什么是Claude开发者平台
该 DOCX 包含不完整的 Office 元数据关系,已使用兼容模式恢复正文和媒体。
什么是Claude开发者平台?
Claude 开发者平台是 Anthropic 用于程序化使用 Claude 构建的基础设施。你不再在浏览器中与 Claude 聊天,而是从代码中发送结构化请求,并获得结构化回复——你可以控制每一个细节:使用哪个模型、花费多少令牌、Claude 可以使用哪些工具,以及它遵循哪些系统指令。
具体来说,平台由几个部分组成:
一个可以从任何语言调用的REST API
不同编程语言的 SDK
命令行接口
一个控制台,你可以管理 API 密钥、监控使用情况、部署托管代理和测试提示
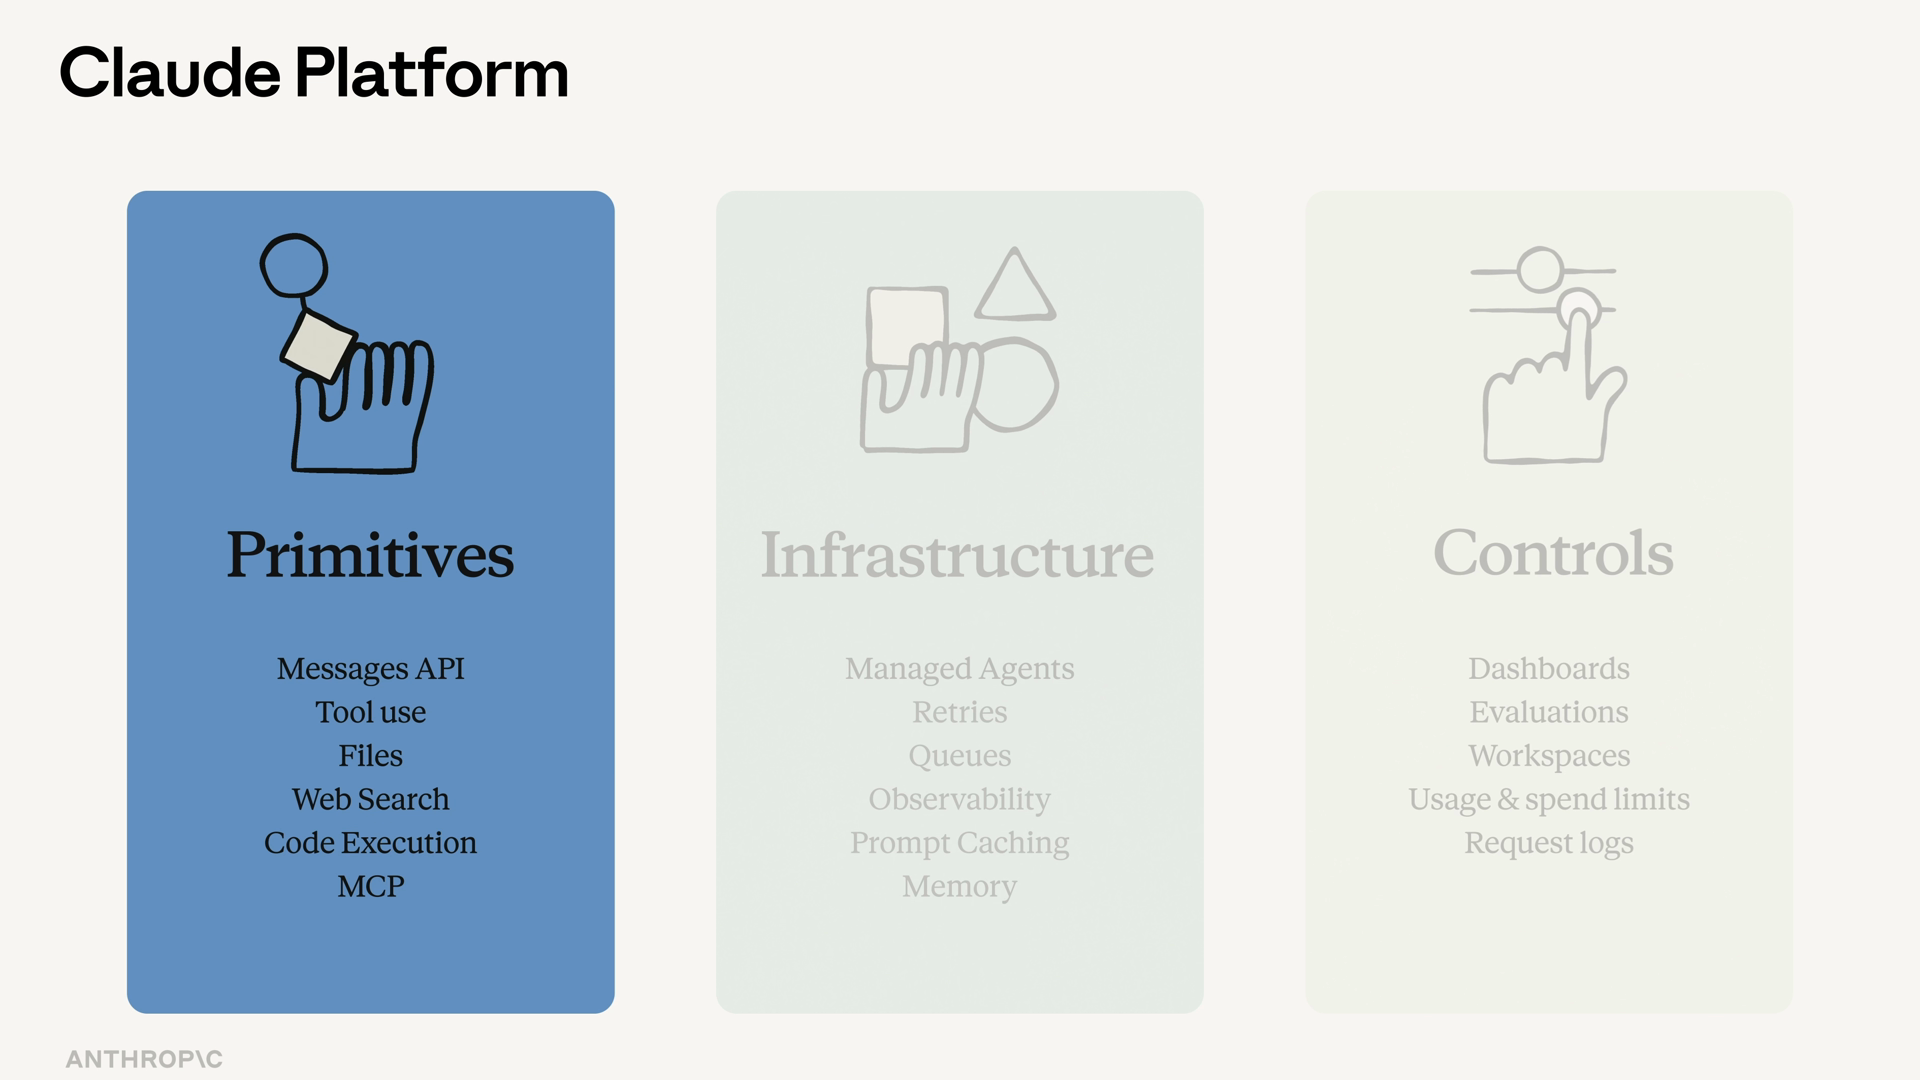
平台的三层结构
一个有用的想象方式是将平台看作三层叠加在一起。
原语——针对Claude调校的API构建模块。这包括消息API、工具使用、文件、网页搜索、代码执行、MCP服务器和技能。这些是你实际调用代码中的部分。
基础设施——构建和扩展代理系统超越原型所需的条件。管理座席、重拨、队列、可观察性——当一个Claude呼叫变成千百个时,这些管道让一切正常运转。
控制——用于在生产环境中运行这些系统的工具,比如仪表盘和评估。这些是你们团队在直播后使用的拨号。
简而言之:用原语建造,基础设施扩展,控制。
你可以在Claude控制台本身看到这种结构——基础设施和控制层都集中在它,包含构建、代理管理和分析等部分。
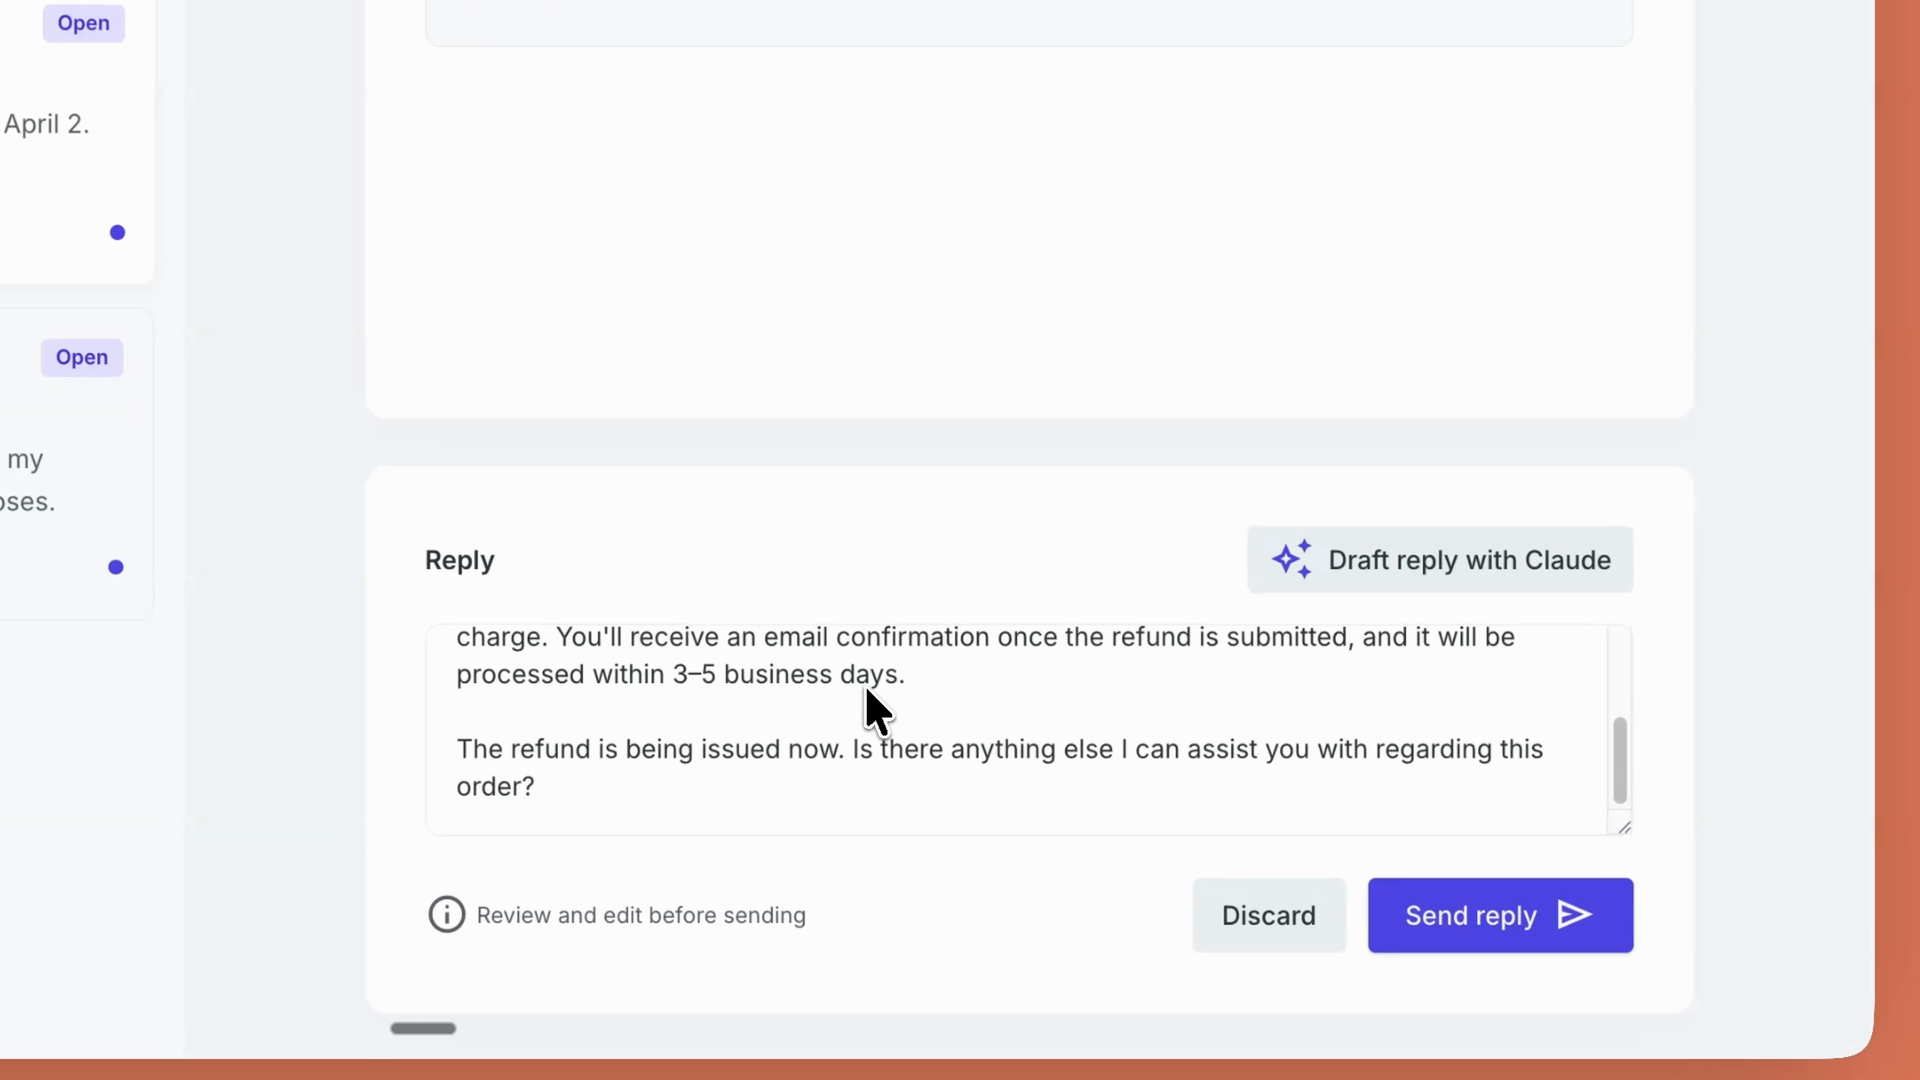
一个真实的例子:起草帮助台回复
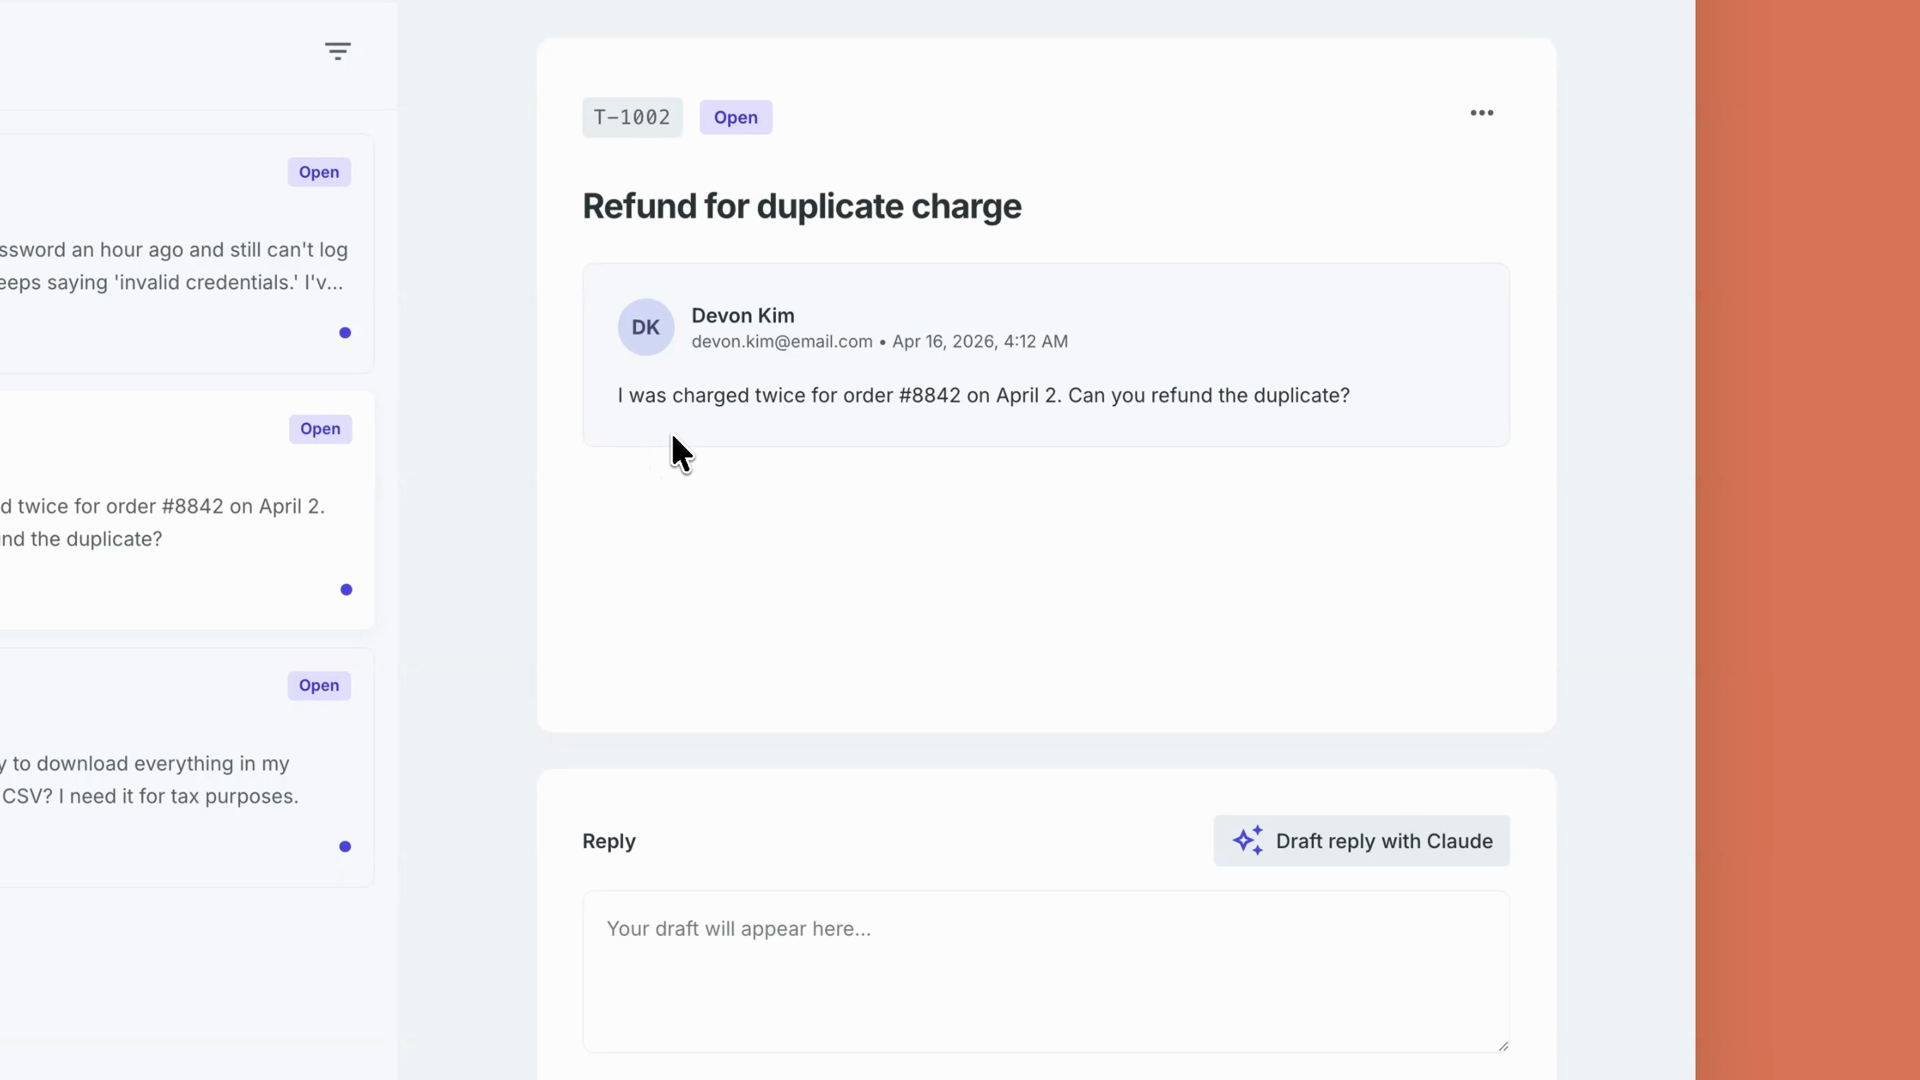
假设你管理一个基础的帮助台应用,有人要求你添加一个功能:根据工单内容起草回复,遵循团队的语气和指导方针。你需要把它连接到界面里的一个按钮。
这正是Messages API的完美用例。流向如下:
定义客户端
取回聊天中提到的工单
叫声messages.create
返回到渲染按钮的响应
client = anthropic.Anthropic()
response = client.messages.create(
model=“claude-haiku-4-5”, # Haiku: a good fit for a simple drafting task
max_tokens=1024,
system=TONE_AND_GUIDELINES,
messages=[
{“role”: “user”, “content”: ticket_content}
],
)
draft = response.content
每个参数都有特定的功能:
模型——哪个型号处理请求。这里的俳句是,因为写回复很简单。
max_tokens——克劳德的回复能有极限。
系统——系统提示词,定义克劳德所扮演的角色。相关语气和指导原则请见此处。
消息——一组对象。该角色告诉克劳德这是用户输入;票据内容都放在那里。user
然后你获取响应,返回到渲染按钮。完成了。
从“问Claude一个问题”到“Claude是我产品的一部分”
注意那个例子中发生了什么:你并不是从零开始构建一个聊天机器人。你是在一个已经存在的产品中添加Claude,API就是你连接它的方式。
这就是核心理念。Claude 平台是你访问 Claude 模型、工具和基础设施的 API 级通道。这就是你如何从向Claude提问到Claude成为我产品的一部分。
当你的产品需要代理时,平台不会直接把模型交给你。托管代理则是帮你运行。
回顾
Claude 开发者平台是 Anthropic 用于编程构建 Claude 的基础设施:REST API、SDK、CLI 以及用于密钥、使用、托管代理和提示测试的控制台。
可以把它看作三层:原语(消息API、工具使用、文件、网页搜索、代码执行、MCP服务器、技能)、基础设施(托管代理、重试、队列、可观察性)和控制(仪表盘、评估)。
简而言之:用原语建造,基础设施扩展,控制。
一次通话就能让你完全控制模型、响应长度、系统提示和用户输入——足以将Claude连接到现有功能中,比如起草帮助台回复。messages.create
这个平台让你从向Claude提问,直接让它成为产品的一部分——而通过托管代理,它还可以帮你运行代理。
你的第一个API调用
和克劳德打个招呼可能会让你感到温暖,但其实没什么用。在这节课中,我们将给Claude发送一个真实的东西,并用不到20行代码获得结构化的见解。
准备好
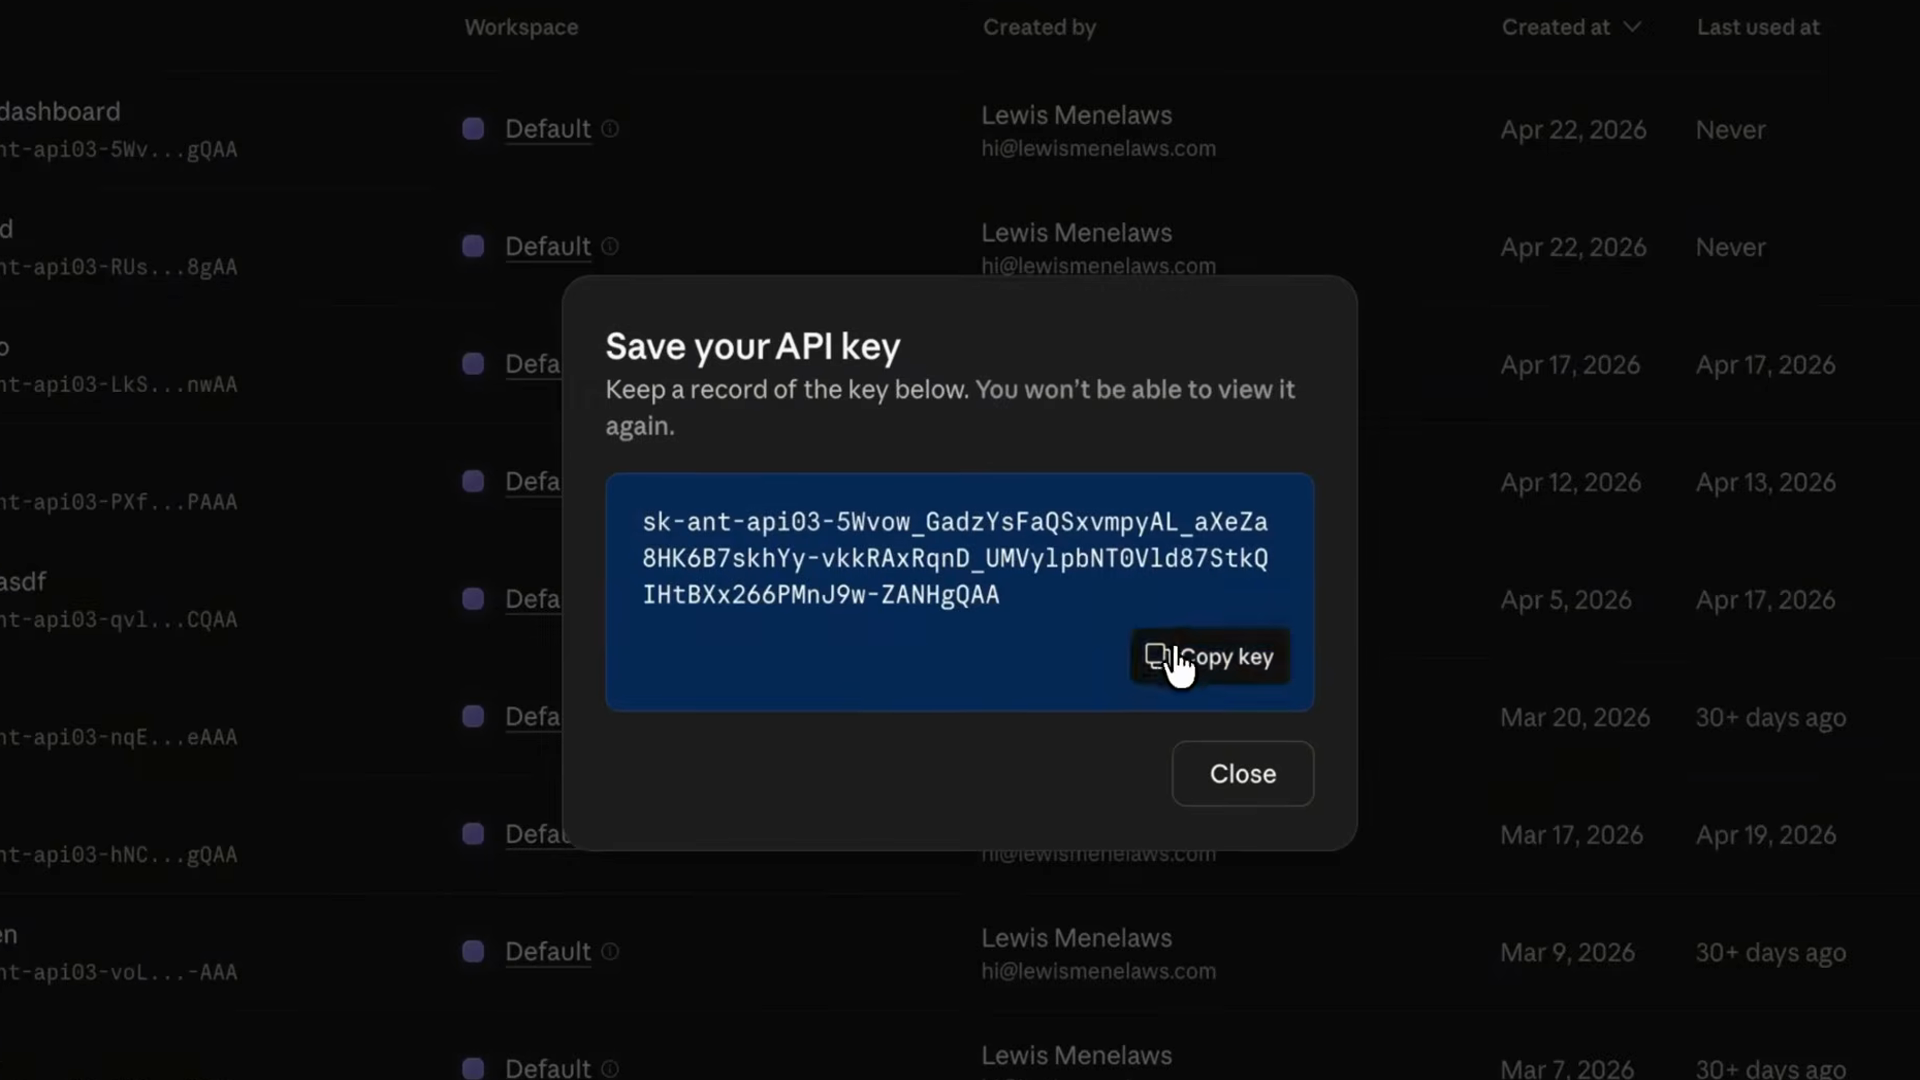
首先,从 platform.claude.com 获取一个API密钥。你需要提前购买一些积分。
把 API 密钥存到文件里,这样就不会被你的版本控制控制。把密钥硬编码在源文件里,导致它们最终泄露到GitHub上——而是把它们保存在环境文件里。.env.local
接下来,安装SDK:
npm install @anthropic-ai/sdk
请求的解剖结构
每个 API 调用都经过 message.create 函数。你具体说明了三件事:
一个模型——由Claude模型处理请求
最大代币限制——对回复时间的限制
一串消息——具有任一或角色的对象,结构类似于你在别处与克劳德对话的方式userassistant
以下是最基本的表现形式:
import Anthropic from “@anthropic-ai/sdk”;
const client = new Anthropic();
const msg = await client.messages.create({
model: “claude-opus-4-7”,
max_tokens: 1024,
messages: [{
role: “user”,
content: “Hello, Claude”,
}],
});
一个真实例子:审查有bug的代码
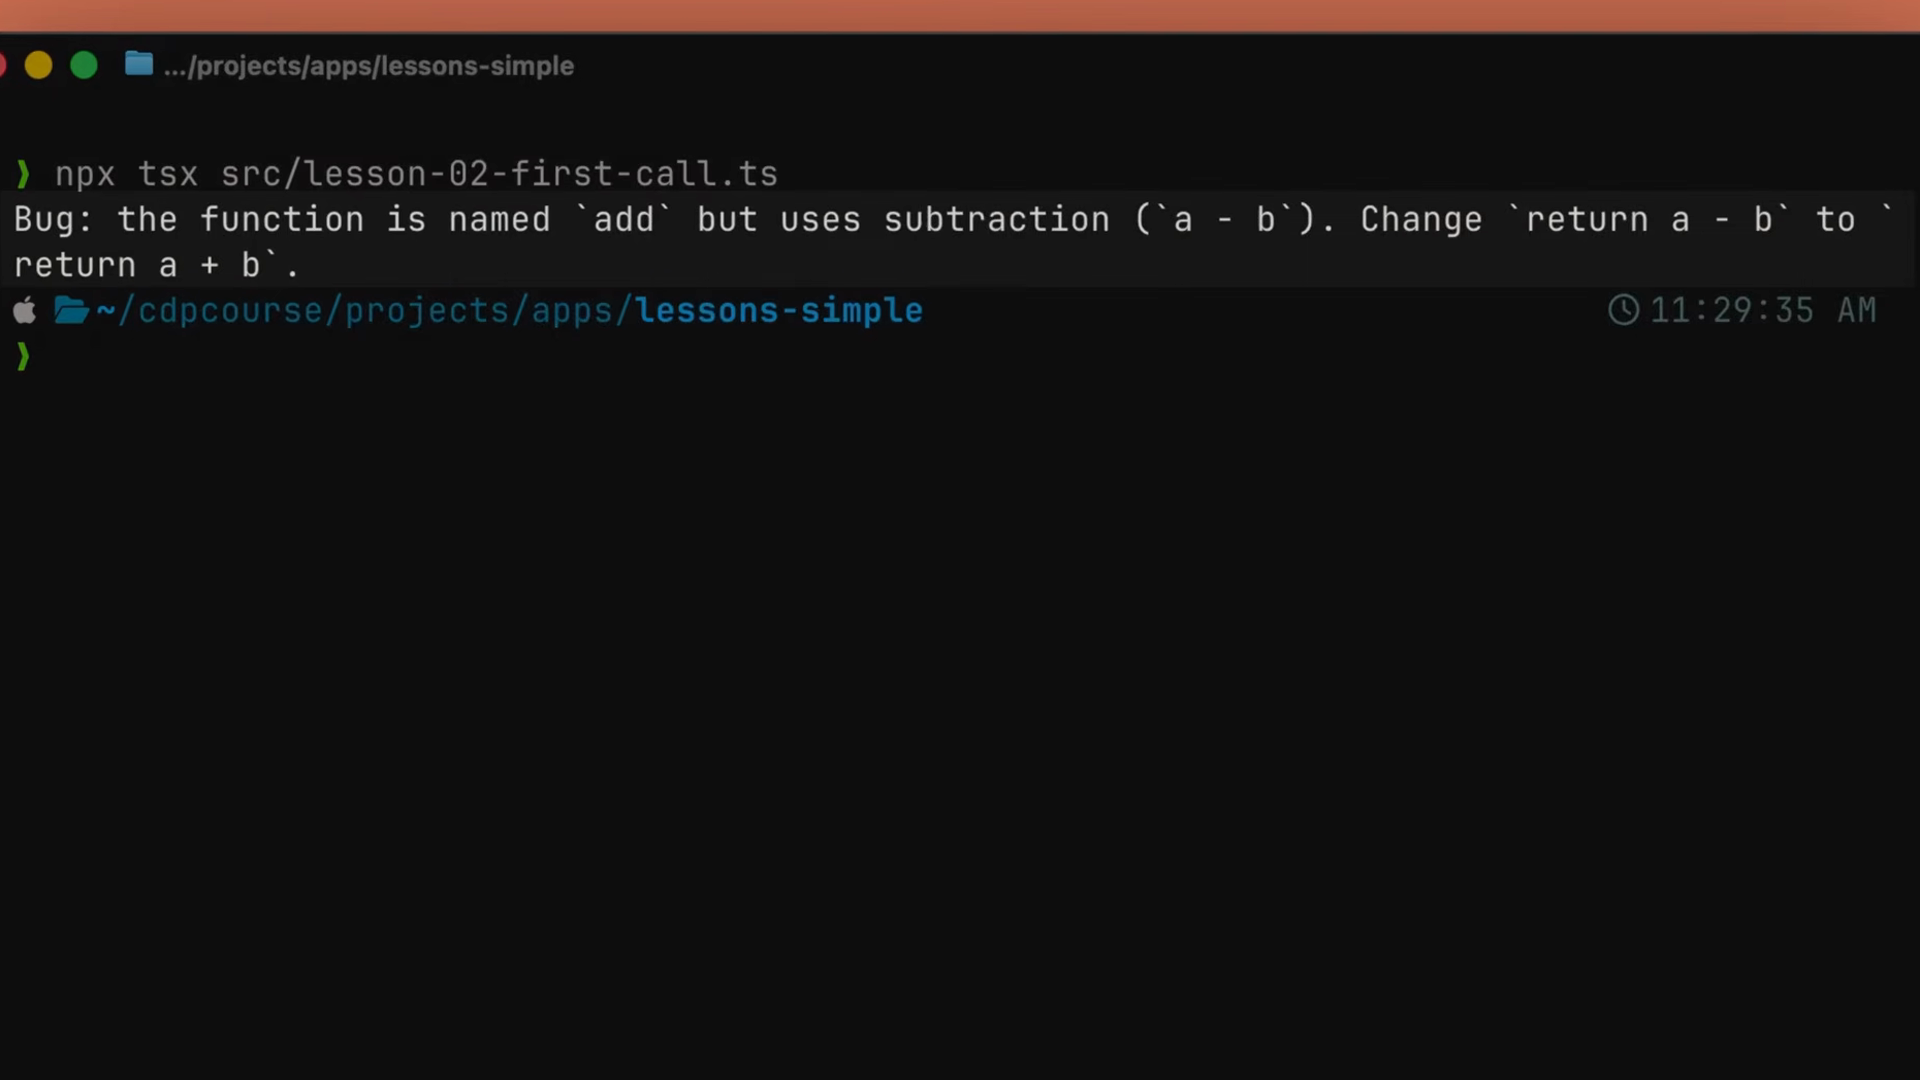
让我们给克劳德点比“你好”更有趣的东西吧。我们会指出某个有漏洞的代码,并请求审核。这是全部——一个文件,大约20行代码:
import Anthropic from “@anthropic-ai/sdk”;
const client = new Anthropic();
const buggyCode = `
function add(a, b) {
return a - b;
}
`;
const response = await client.messages.create({
model: “claude-opus-4-8”,
max_tokens: 1024,
system: “You are a terse senior code reviewer. Give feedback in one paragraph.”,
messages: [
{ role: “user”, content: Review this code:\n${buggyCode} },
],
});
for (const block of response.content) {
if (block.type === “text”) {
console.log(block.text);
}
}
这里有两点需要注意:
系统提示词是你塑造人格的地方。我想要一个简洁的资深审稿人,而不是话多的——所以我就这么说。
响应中的 message.content 是一个块数组,而不是字符串。对于一个基本的文本回复,通常只有一个类型为 的块,但 Claude 可以返回多个块——文本、工具调用、思考——所以我们总是循环检查类型。text
运行它,Claude会发现这是减法,并在一段话里告诉你。就这样。这就是整个API调用。add
从剧本到产品
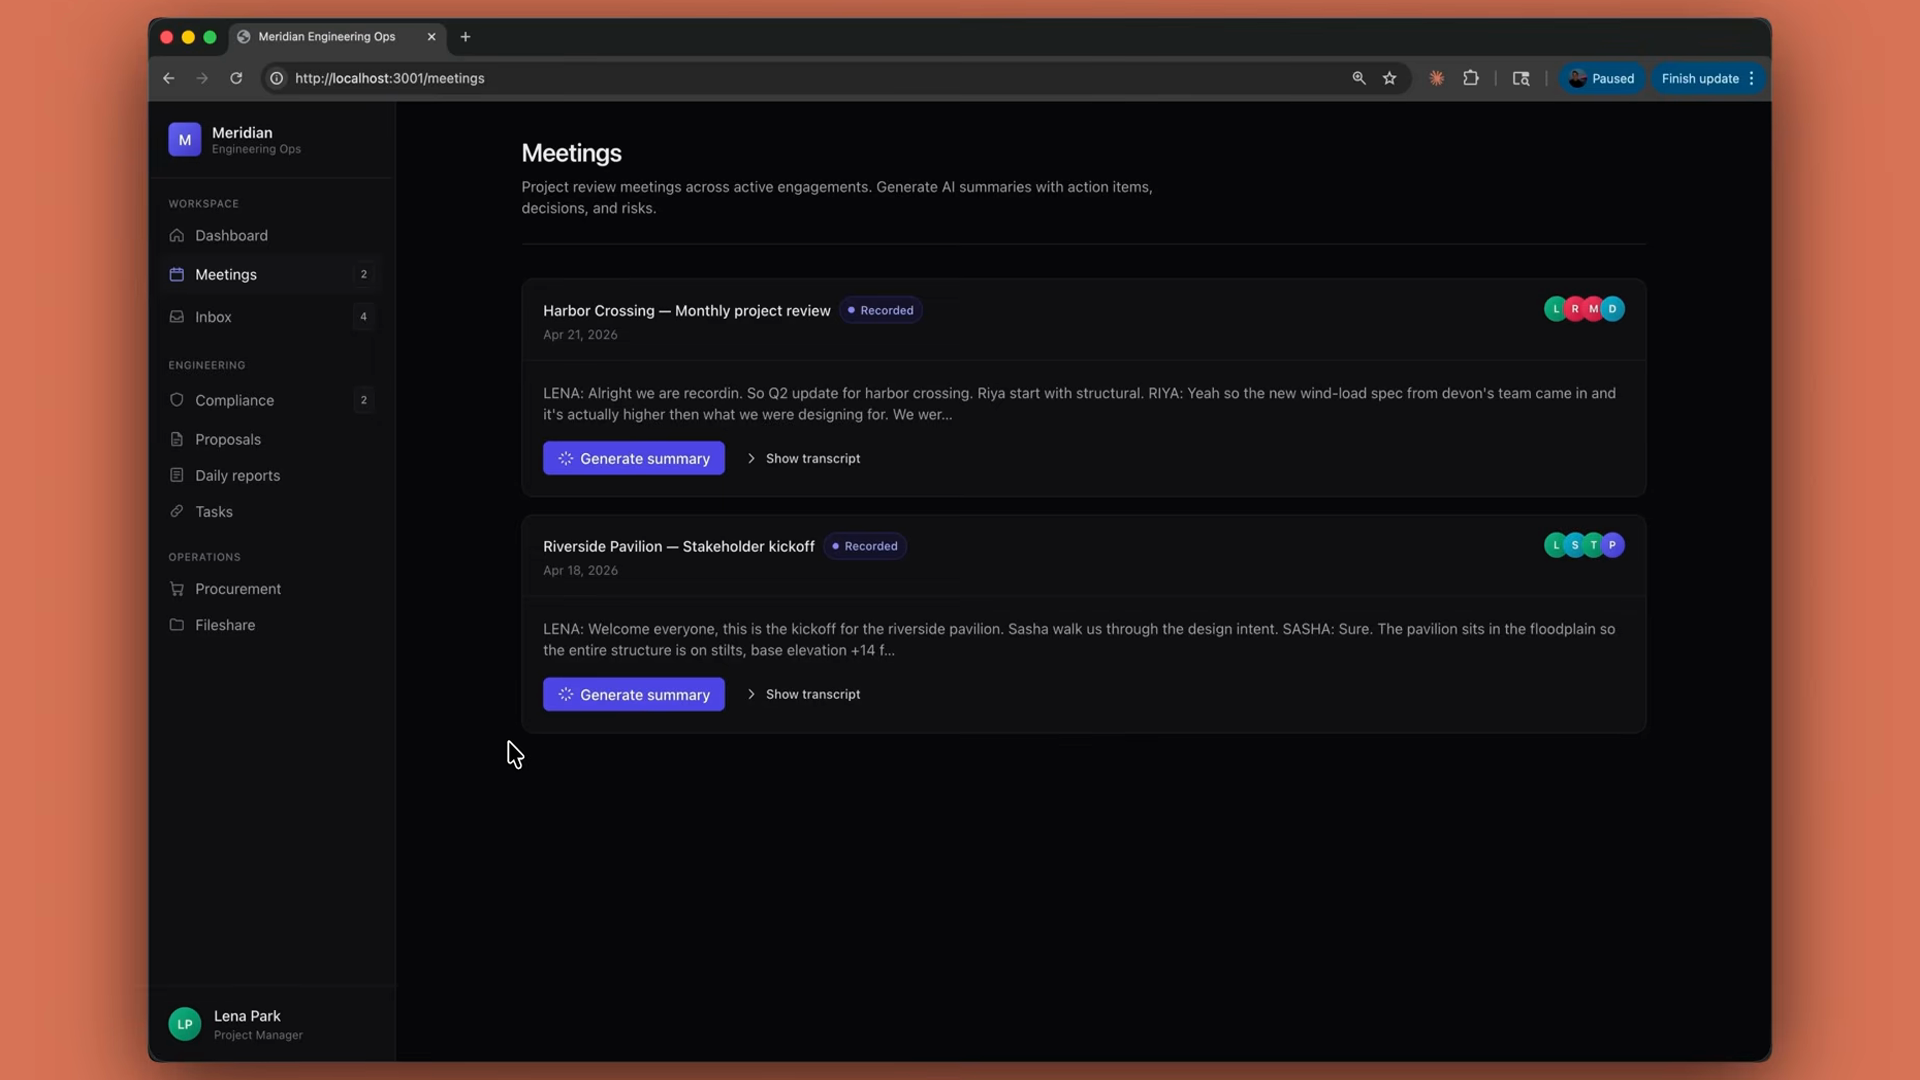
在真实产品中,这个形状是类似总结端点的引擎。从数据库中提取会议记录,交给Claude,并提示“提取洞察和风险”,然后将结果保存回该行,然后返回界面。这其实是同一个判罚——只是被一个路线处理器包裹起来了。messages.create
回顾
你的第一个 API 调用是一个 messages.create 函数,里面有模型、令牌限制和消息。
把你的API密钥存档,避免被版本控制。.env.local
添加系统提示来塑造Claude的行为。
响应是一个分组数组——循环并检查每个分组的 。contenttype
从这里开始,一切都建立在这个模式之上。
选择合适的模型
你是在用Claude发布一个应用。你选哪个型号?如果你默认选最聪明的那一个,你的API账单会让你大吃一惊。选最便宜的,输出可能撑不住。每种型号都有不同的权衡,选择合适的会影响质量和成本。
模型等级
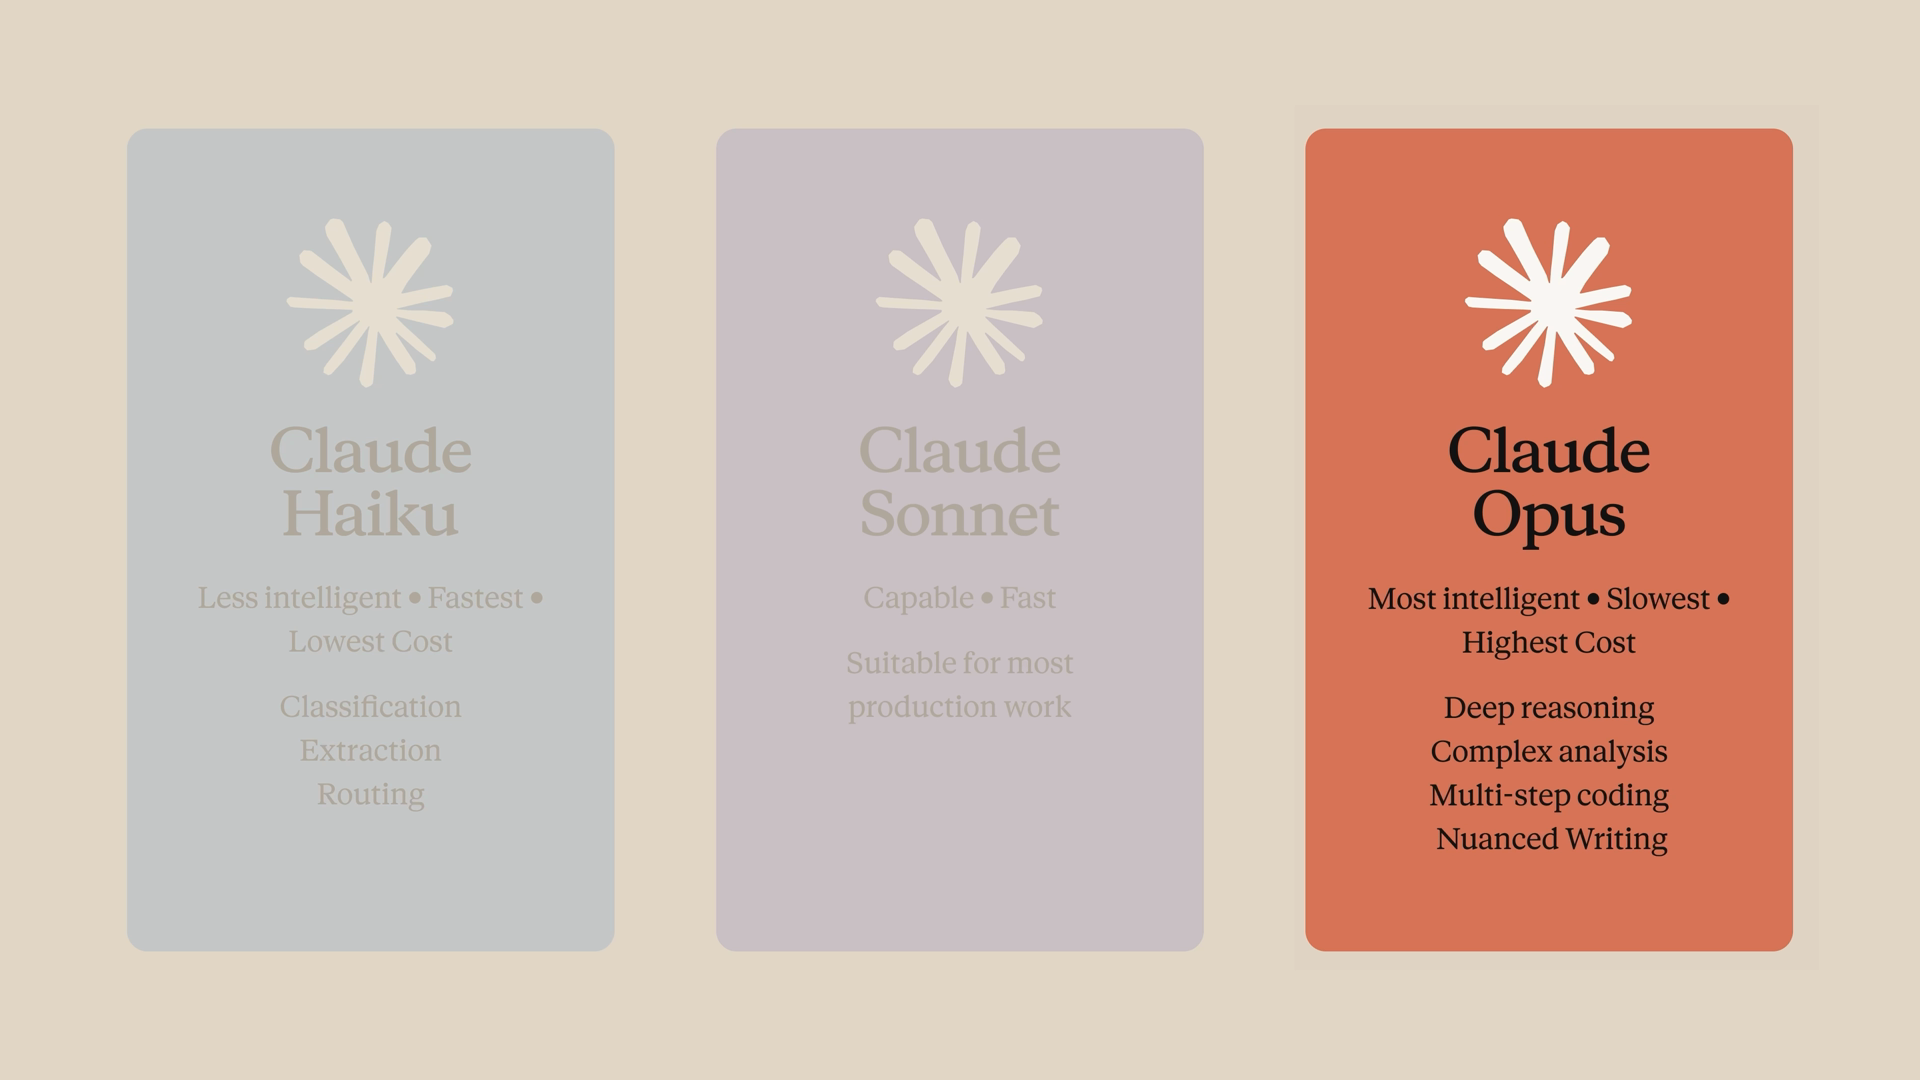
Anthropic目前提供四个模型层级,你可以在API调用中根据参数选择。model
请注意,在本课程开始时,Claude Fable尚未公开使用,且未反映在上方视频中。了解更多关于克劳德·寓言和克劳德·神话的信息给你.
Claude Fable是我们迄今为止最强大的型号——一个高于Opus的新层级,专为你最艰难的挑战打造。它的成本远高于Opus,所以应留给那些额外能力值得付出的使用。
Claude Opus 是三大核心型号家族中最强大的,但同时也是最慢且成本最高的。用于深度推理、复杂分析、多步骤编码和细致写作。
Claude Haiku 是最快且成本最低的,优化为速度和成本效益,而非最大化智能。用它做大批量、低复杂度的工作,比如分类、提取和路由。
《克劳德·索内特》正好处于此:智慧、速度和成本的平衡结合,非常适合大多数制作工作。
从简单的评估开始
在编写生产代码之前,先设置一个简单的评估:一组示例输入,逐个模型运行,并根据良好输出对你的用例意味着什么来进行评分。你不需要什么花哨的——20到30个代表性例子就足够开始了。
然后逐步提升等级:
先用俳句来讲你的例子。如果质量保持不变,你就完成了——而且你省下了不少钱。
如果不行,那就去做《十四行诗》吧。
只有在任务需要时才用Opus。
并排比较各阶级
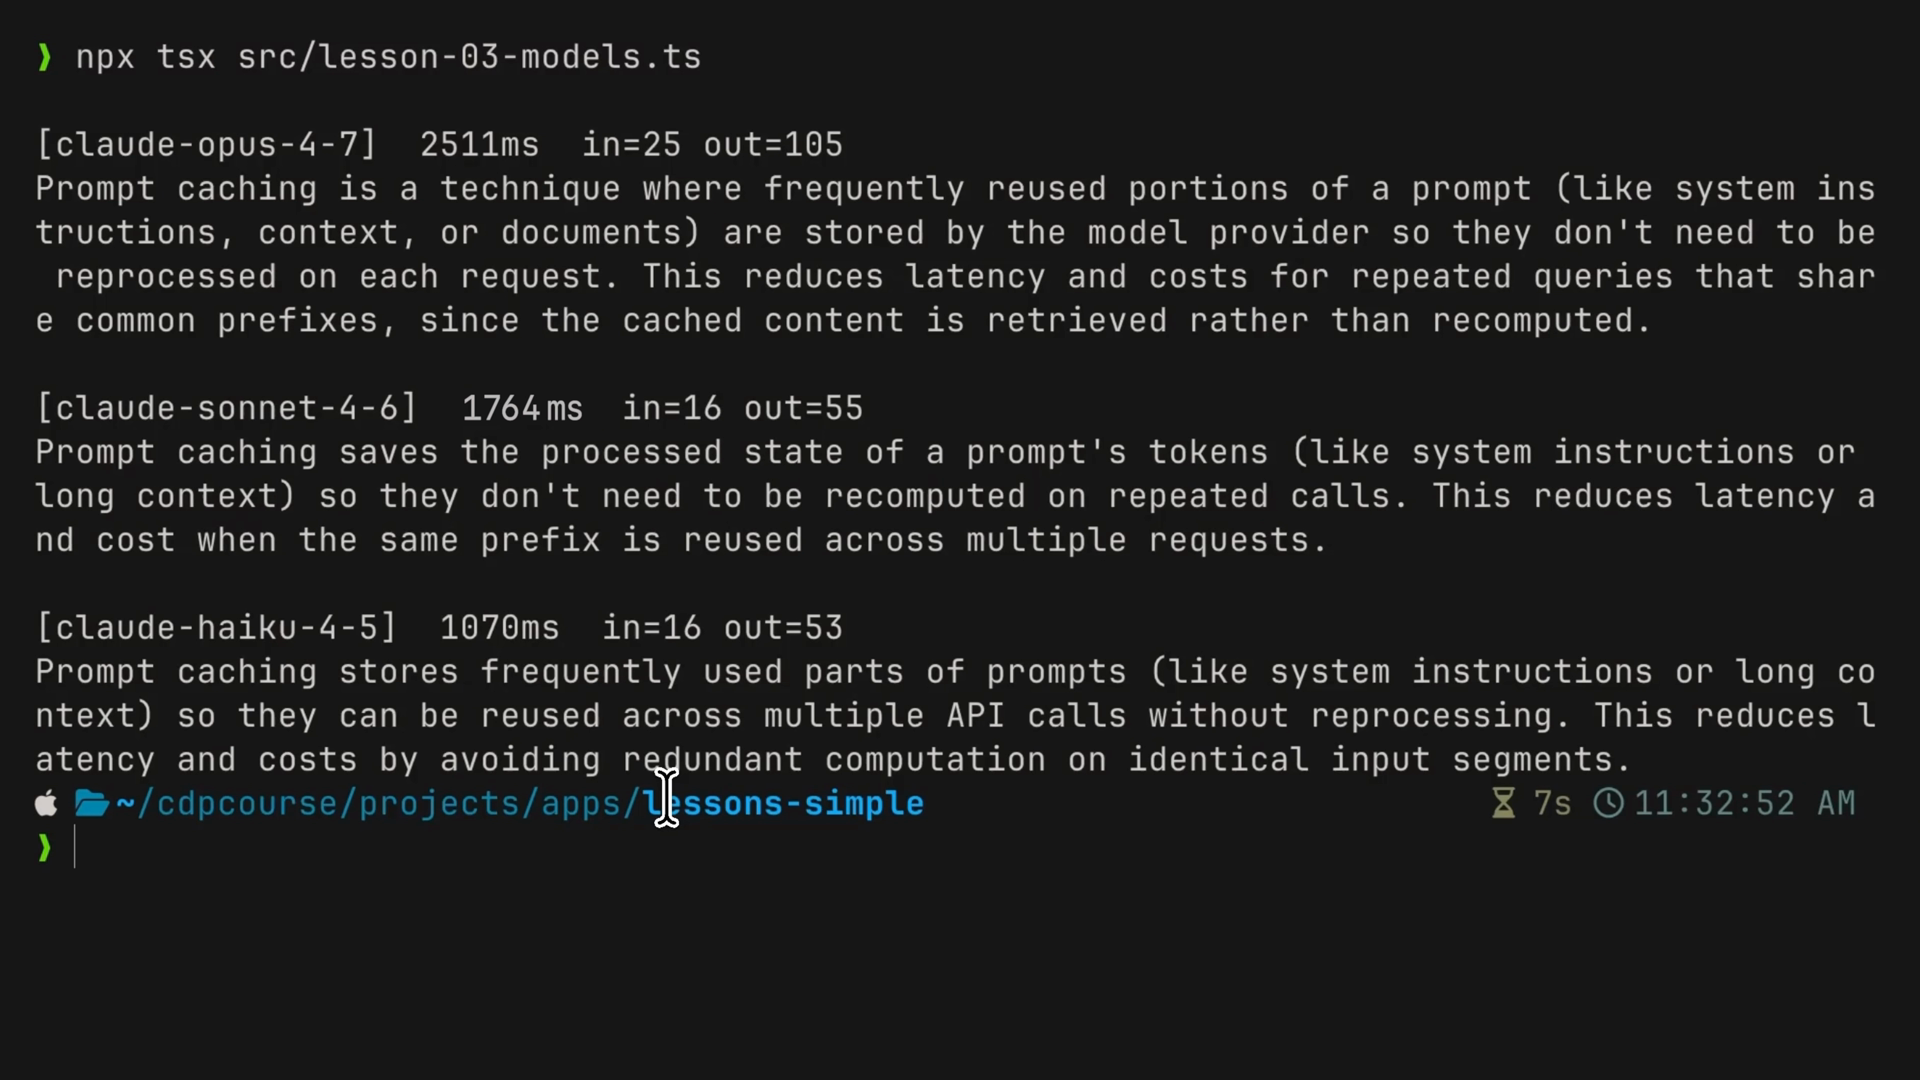
让我们看看不同层级之间的区别,而不是仅仅谈论。我们将在三种型号中发送同一个提示,并观察延迟和令牌计数:
models = [“claude-haiku-4-5”, “claude-sonnet-4-6”, “claude-opus-4-7”]
for model in models:
response = client.messages.create(
model=model,
max_tokens=300,
messages=[{“role”: “user”, “content”: prompt}],
)
print(model, response.usage)
这里有两件事:
循环在每次请求时交换字段。同样的提示,同样的max代币——只是模型变了。model
response.usage它直接从API中获得输入和输出令牌,这也是你的计费计算依据的。
运行它,你会看到三个模型和三组数字。《Opus》花的时间最长,阅读最精致——但对于两句话的定义来说,这种润色是浪费的。十四行诗稍微收紧了写作。而俳句通常不到一秒钟就回来,给出一个非常称职的两句话回答。说实话,这很适合这种情况。
这正是关键:合适的型号是你实际会出货的最便宜的那个。作为定义,俳句就足够了。起草监管回复时,你也会做同样的对比,可能会用到Opus。每次评估都是同一个形状。
将不同工作分配到不同模型
在真实应用中,你会将不同类型的工作路由到同一个端点的不同模型。以一个带有文档处理路径的运营仪表盘为例:
每个进来的文件都会被用俳句分类。
客户更新是用Sonnet起草的。
只有招标回复会覆盖 Opus。
一个队列,三个模型,每个任务选。
回顾
Anthropic提供三个模型等级:用于难题的Opus、日常工作的十四行诗和体积的俳句。
在写生产代码之前,先设置一个简单的评估——20到30个代表性示例,来自你的真实工作量。
从俳句开始,从评分开始,最终选择你实际会出货的最便宜型号。
response.usage报告输入和输出令牌,这就是你的账单的基础。
在生产环境中,将不同任务路由到同一端点内的不同模型,而不是为所有任务选一个模型。
代理循环解释道
视频
代理循环解释道
你已经调用了API,但一次调用只返回一个响应。如果你想自动化工作流程,Claude需要行动,查看结果,决定下一步,然后继续前进。这种模式就是人们所说的代理性工作流。
代理人到底是什么
代理是克劳德的自主版本,负责消息循环的两端,中间没有人类介入。代理接收任务后选择工具,并循环执行代码,直到 Claude 决定任务完成。
实现代理循环最简单的方法是这样:
给Claude发消息,附上可用的工具。
Claude会回复最终答案或请求使用你定义的工具。
你的代码执行了这个工具。
你把结果发回给克劳德。
重复直到停止原因为 。end_turn
可以把它想象成一场对话,回合交替进行:用户先启动,代理呼叫工具,工具返回结果,代理继续操作直到得到答案。
一个简约的工作示例
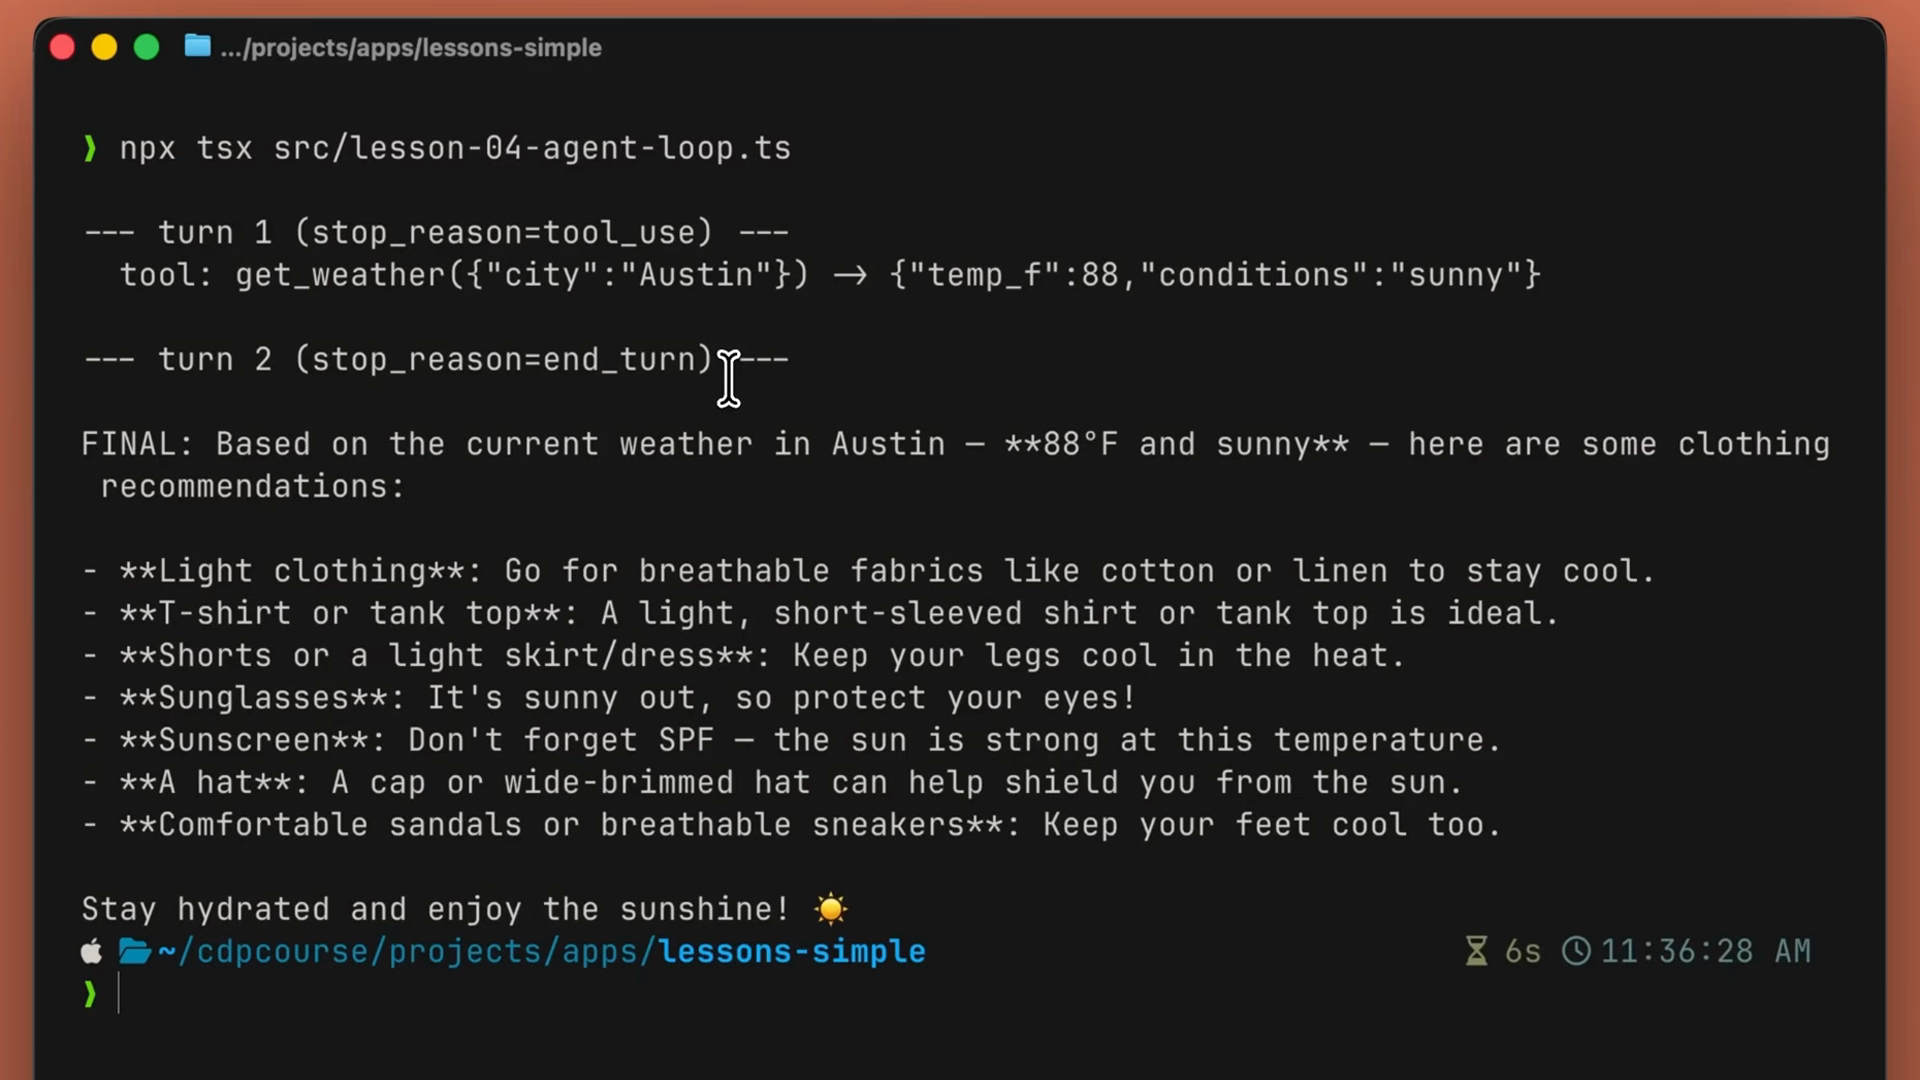
为了让这个循环从头到尾运行而不拖入数据库或界面,我们将接线一个名为“假工具”的假工具,问Claude今天在奥斯汀该穿什么。Claude自己无法判断天气,所以必须调用工具,读取结果,然后给你答案。get_weather
以下是完整的剧本:
import anthropic
client = anthropic.Anthropic()
The tools array tells Claude what’s available:
a name, a description, and a JSON schema for the inputs.
tools = [
{
“name”: “get_weather”,
“description”: “Get the current weather for a city.”,
“input_schema”: {
“type”: “object”,
“properties”: {
“city”: {
“type”: “string”,
“description”: “The city to get weather for”,
}
},
“required”: [“city”],
},
}
]
run_tool is just a hardcoded lookup.
In a real app, this would hit your database, an API, whatever.
def run_tool(name, tool_input):
if name == “get_weather”:
return f“Weather in {tool_input[‘city’]}: 95F, sunny”
raise ValueError(f“Unknown tool: {name}”)
messages = [
{“role”: “user”, “content”: “What should I wear in Austin today?”}
]
The agent loop. Each iteration sends messages to Claude
and switches on the response’s stop reason.
while True:
response = client.messages.create(
model=“claude-sonnet-4-6”,
max_tokens=1024,
tools=tools,
messages=messages,
)
if response.stop_reason == “end_turn”:
Claude is done. Print the final text and break.
for block in response.content:
if block.type == “text”:
print(block.text)
break
if response.stop_reason == “tool_use”:
Find the tool use blocks in the response and run each one.
tool_results = []
for block in response.content:
if block.type == “tool_use”:
result = run_tool(block.name, block.input)
tool_results.append(
{
“type”: “tool_result”,
“tool_use_id”: block.id,
“content”: result,
}
)
Push the assistant’s response and our tool results
back into messages, then loop again so Claude can answer.
messages.append({“role”: “assistant”, “content”: response.content})
messages.append({“role”: “user”, “content”: tool_results})
有三件值得注意的事:
工具数组告诉 Claude 可用内容:一个名称、一个描述,以及一个输入的 JSON 模式。
run_tool只是硬编码的查询。在真实应用中,这会影响你的数据库、API,或者其他什么。
环路就是代理环路。每次迭代都会将消息发送给Claude,并启用响应的停止理由。在 ,Claude 完成——打印最终文本并分开。在 ,找到工具使用区块,逐个运行,将助手的响应和工具结果推回 ,然后再次循环,让Claude回答。end_turntool_usemessages
运行
运行脚本时,你会看到两个回合:
第一回合:停止原因为。Claude请求奥斯汀,你的代码返回温度和条件。tool_useget_weather
第二回合:停车原因是,克劳德让你穿轻便透气的衣服。end_turn
两次API调用,一次工具执行,一次最终回复。这就是整个循环。你用 Claude API 构建的所有东西都会类似这个。
同样的制作循环
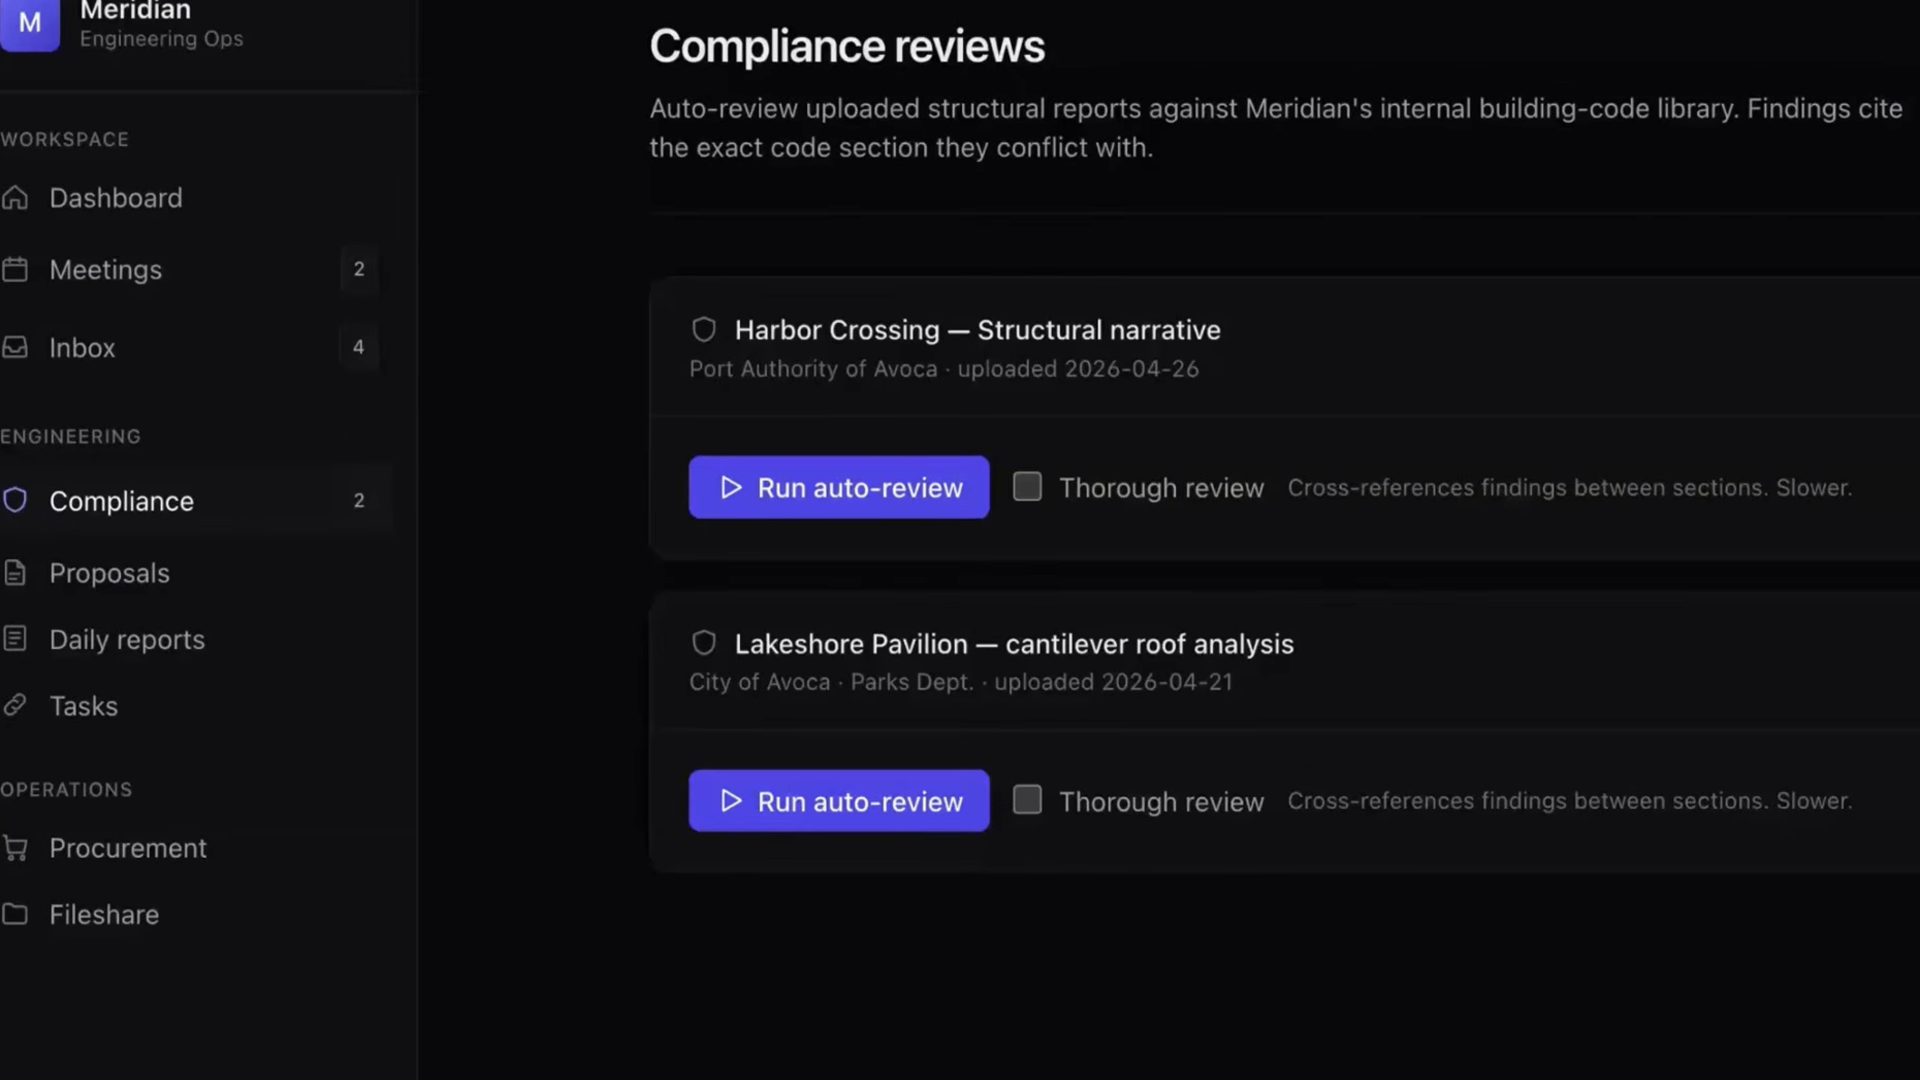
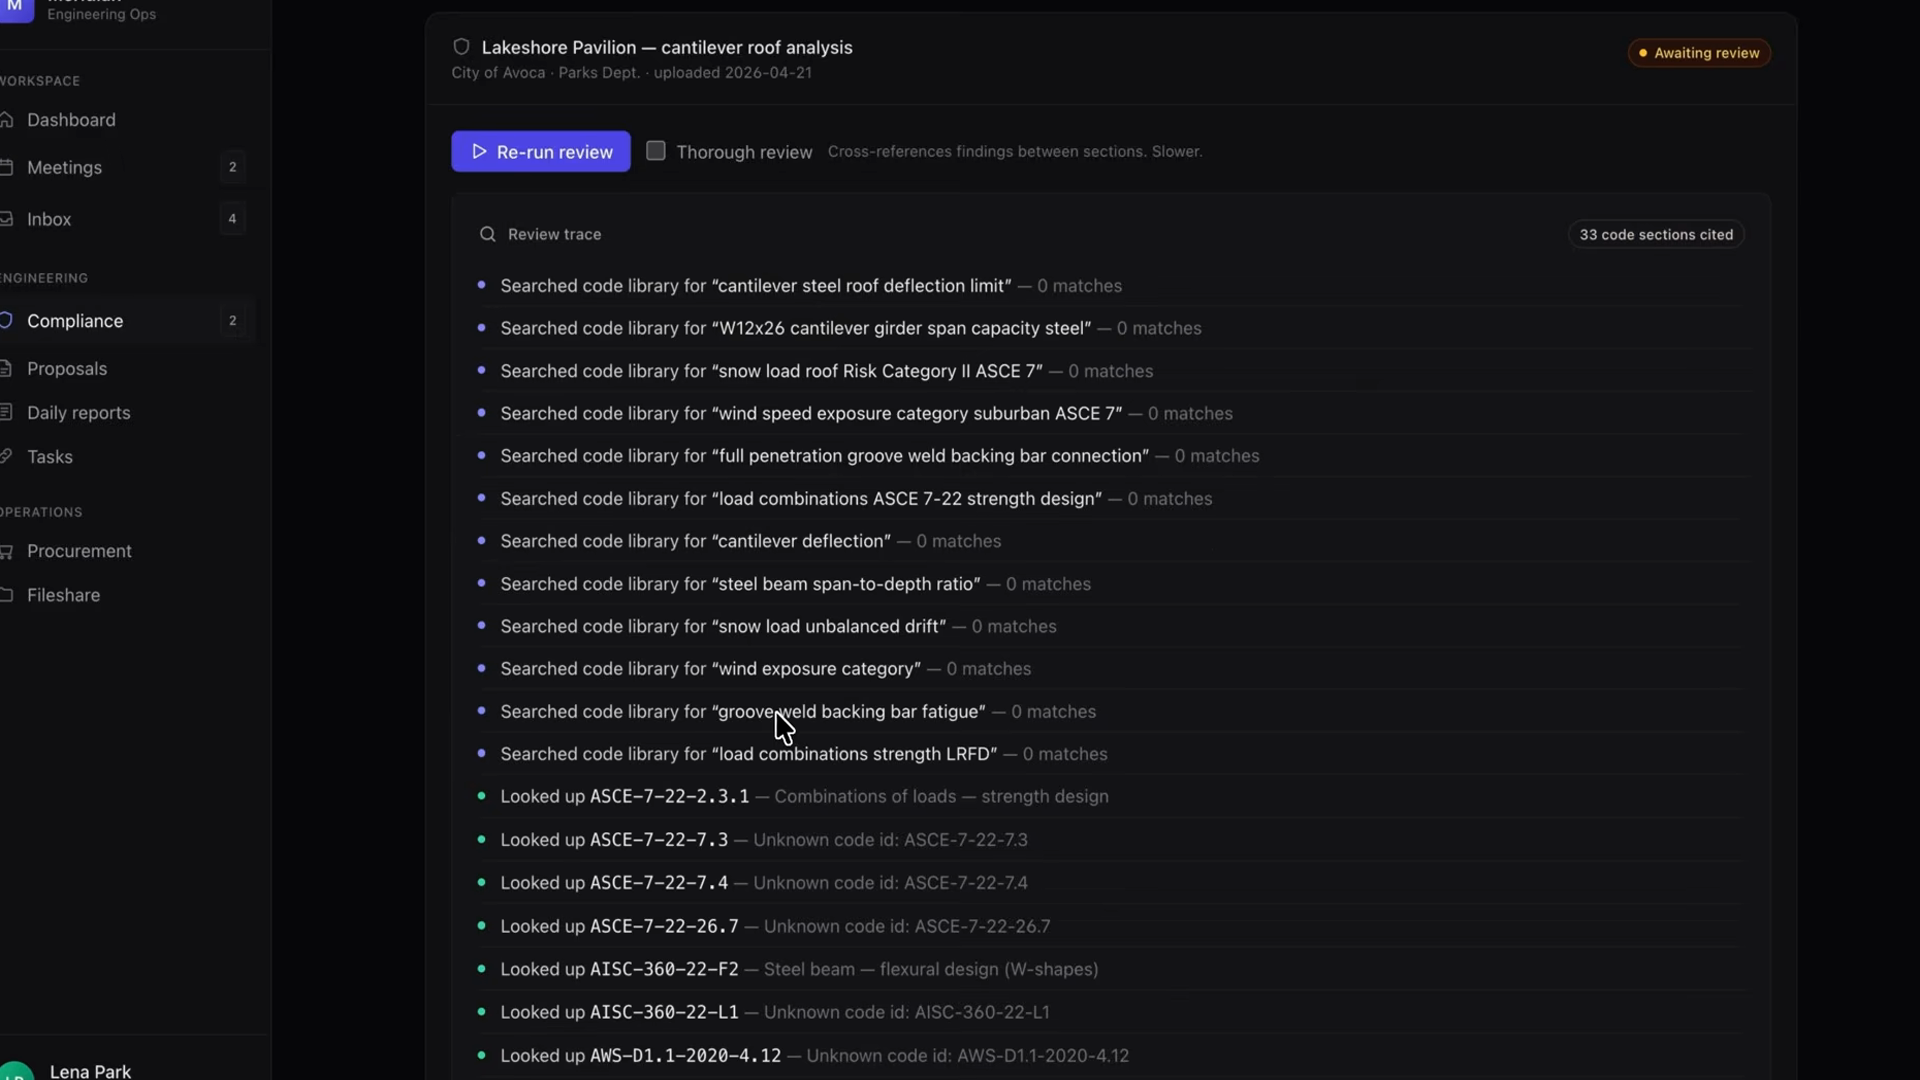
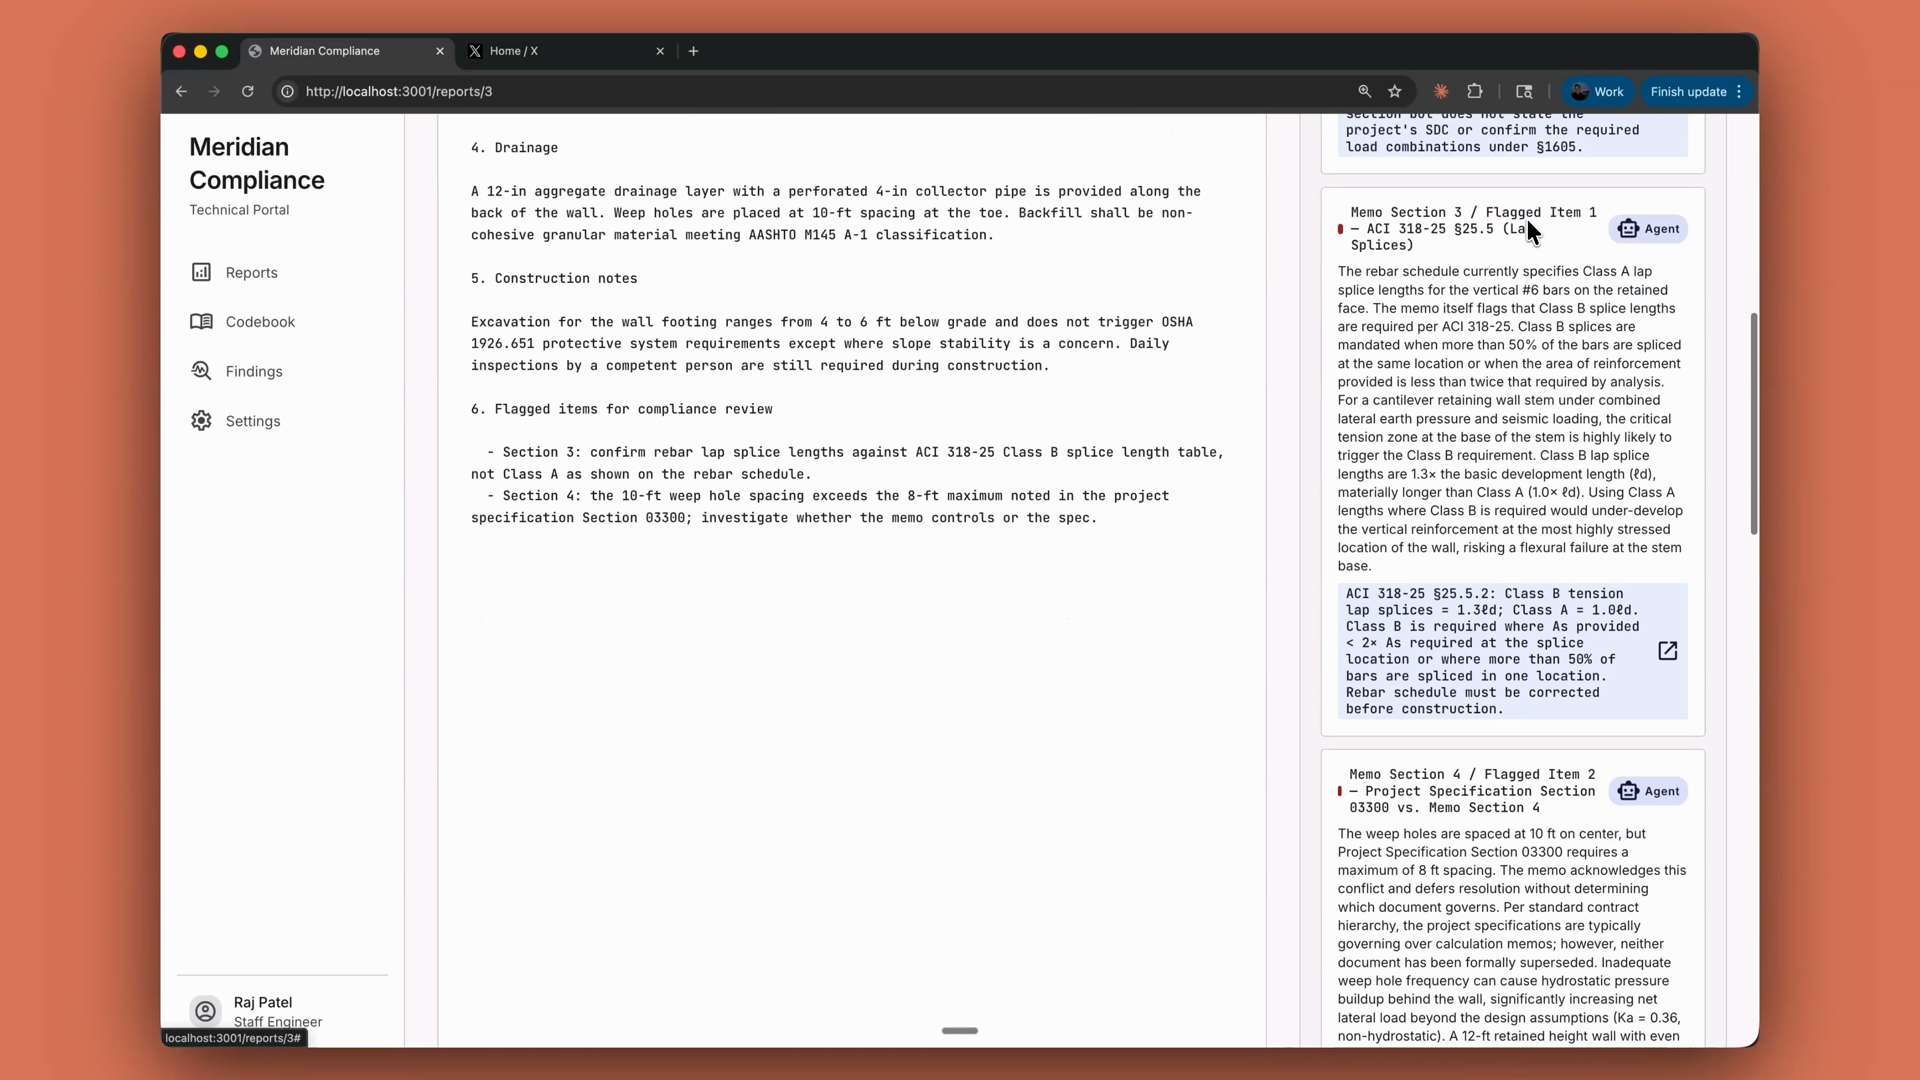
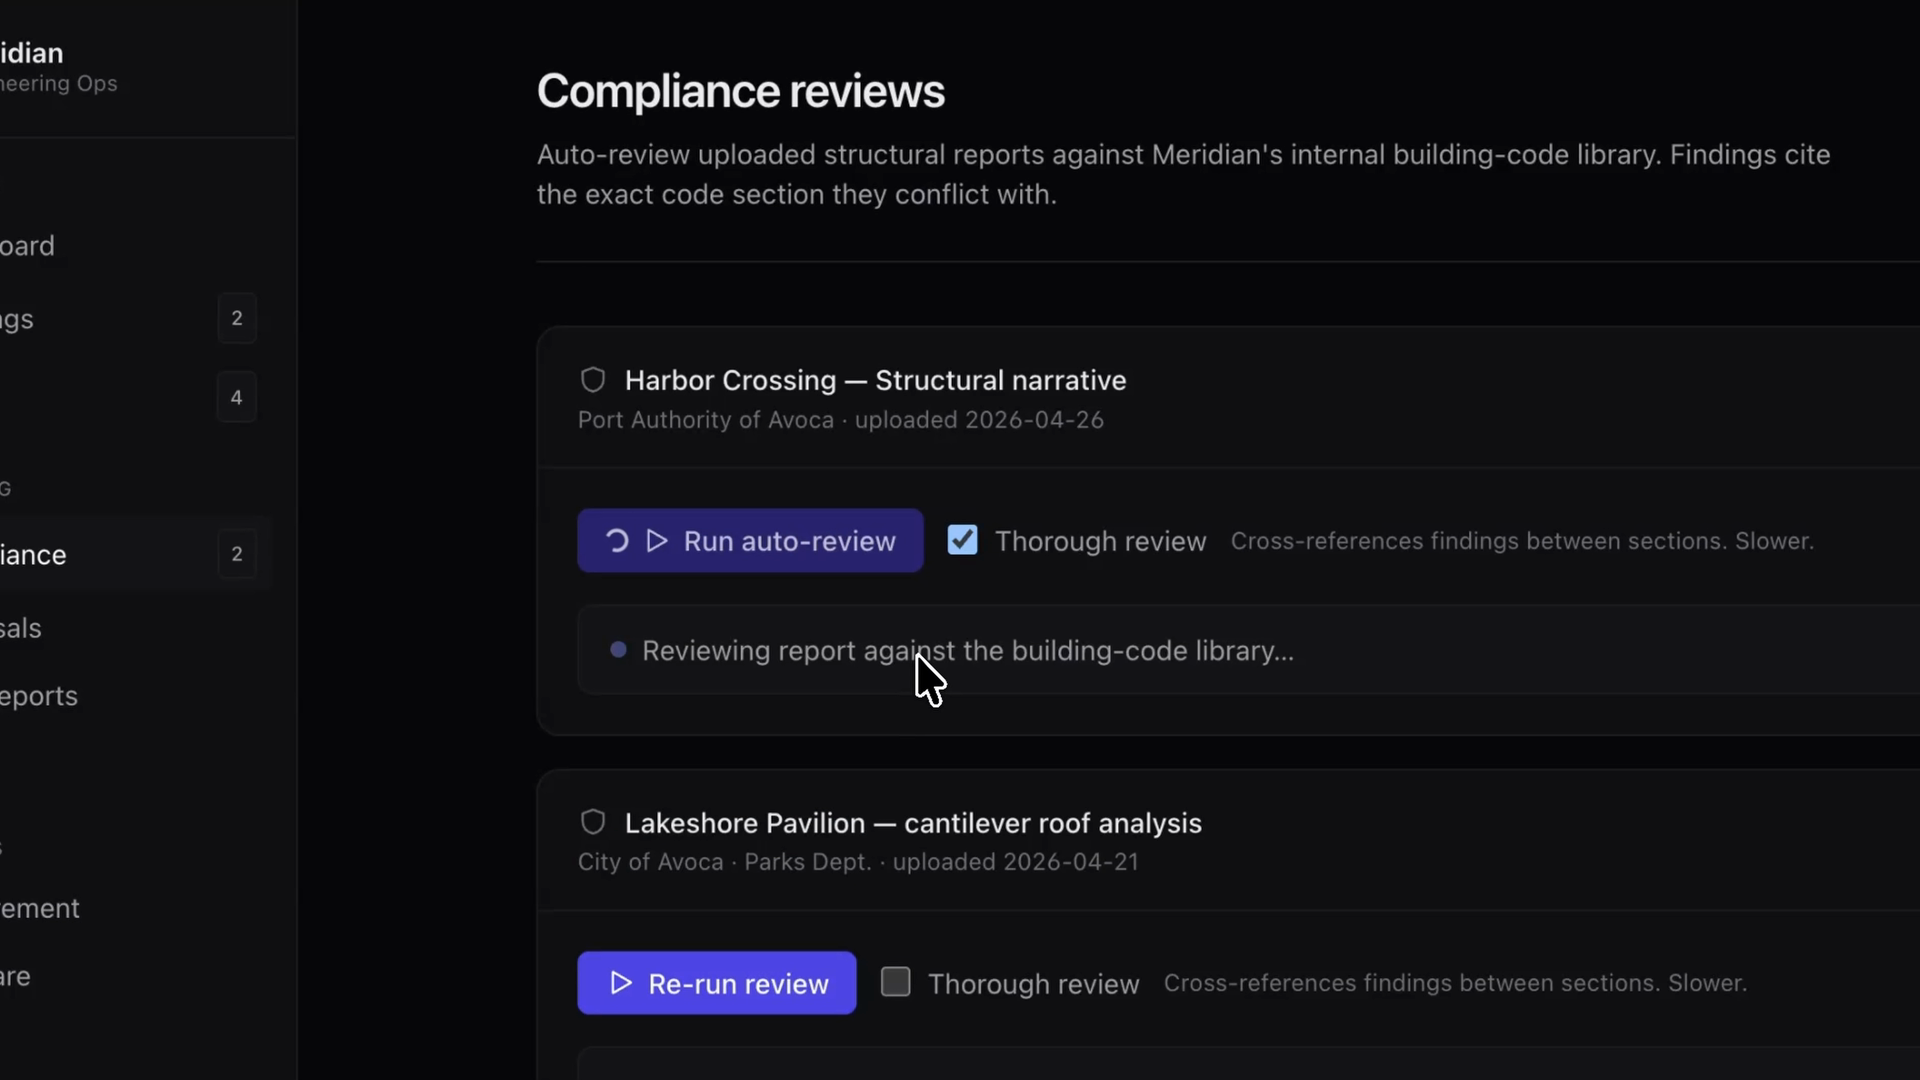
在真实环境中,同样的循环驱动着类似自动审查终端的功能:一个合规代理,阅读结构报告,通过工具查找相关建筑规范,并在运行过程中逐一将风险发现写回数据库。
环形结构和你刚才跑的完全一样。区别在于:
用真正的工具代替模拟天气查询。
结果会以服务器发送的事件形式流回界面。
发现会被保存到风险检测表。
回顾
代理人就像克劳德在循环中:观察、决定、行动、重复。
循环很简单:发送带有工具的消息,运行任何工具 Claude 请求,反馈结果,停止原因为 时停止。end_turn
你拥有这条循环和工具。克劳德对这个理由很有把握。
同样的环形从模拟天气演示扩展到生产合规代理——只是工具和管道发生了变化。
当你不想拥有循环时,托管代理会在Anthropic的基础设施上为你运行完全相同的循环。
什么是工具使用?
视频
什么是工具使用?
你现有的工作流程依赖于许多不同的技术——项目管理软件、数据库、文件。克劳德不能自己检查这些东西。相反,它依赖工具,这些工具让Claude能够访问外部数据和操作。
什么是工具
简单来说,工具就是你定义并展示给Claude的函数。你描述它的功能和需要的输入,克劳德决定何时调用。
关键要内化的是:Claude 不是执行工具本身——是你的代码执行。流向如下:
克劳德请求调用工具。
你的代码执行函数。
结果回到了克劳德手中,并且一直延续。
工具的定义方式
工具是包含三部分的JSON模式:名称、描述和输入模式。你把它们作为数组在请求体中传递给Claude。tools
描述是克劳德阅读后决定是否调用工具的内容。如果你写得很模糊,工具使用会很糟糕。这也是经纪人误用或不利用现有工具的头号原因。具体点。
工具定义大致如下:
{
“name”: “lookup_building_code”,
“description”: “Look up a specific building code section by its identifier. Returns the full text of that code section.”,
“input_schema”: {
“type”: “object”,
“properties”: {
“section”: {
“type”: “string”,
“description”: “The building code section to look up”
}
},
“required”: [“section”]
}
}
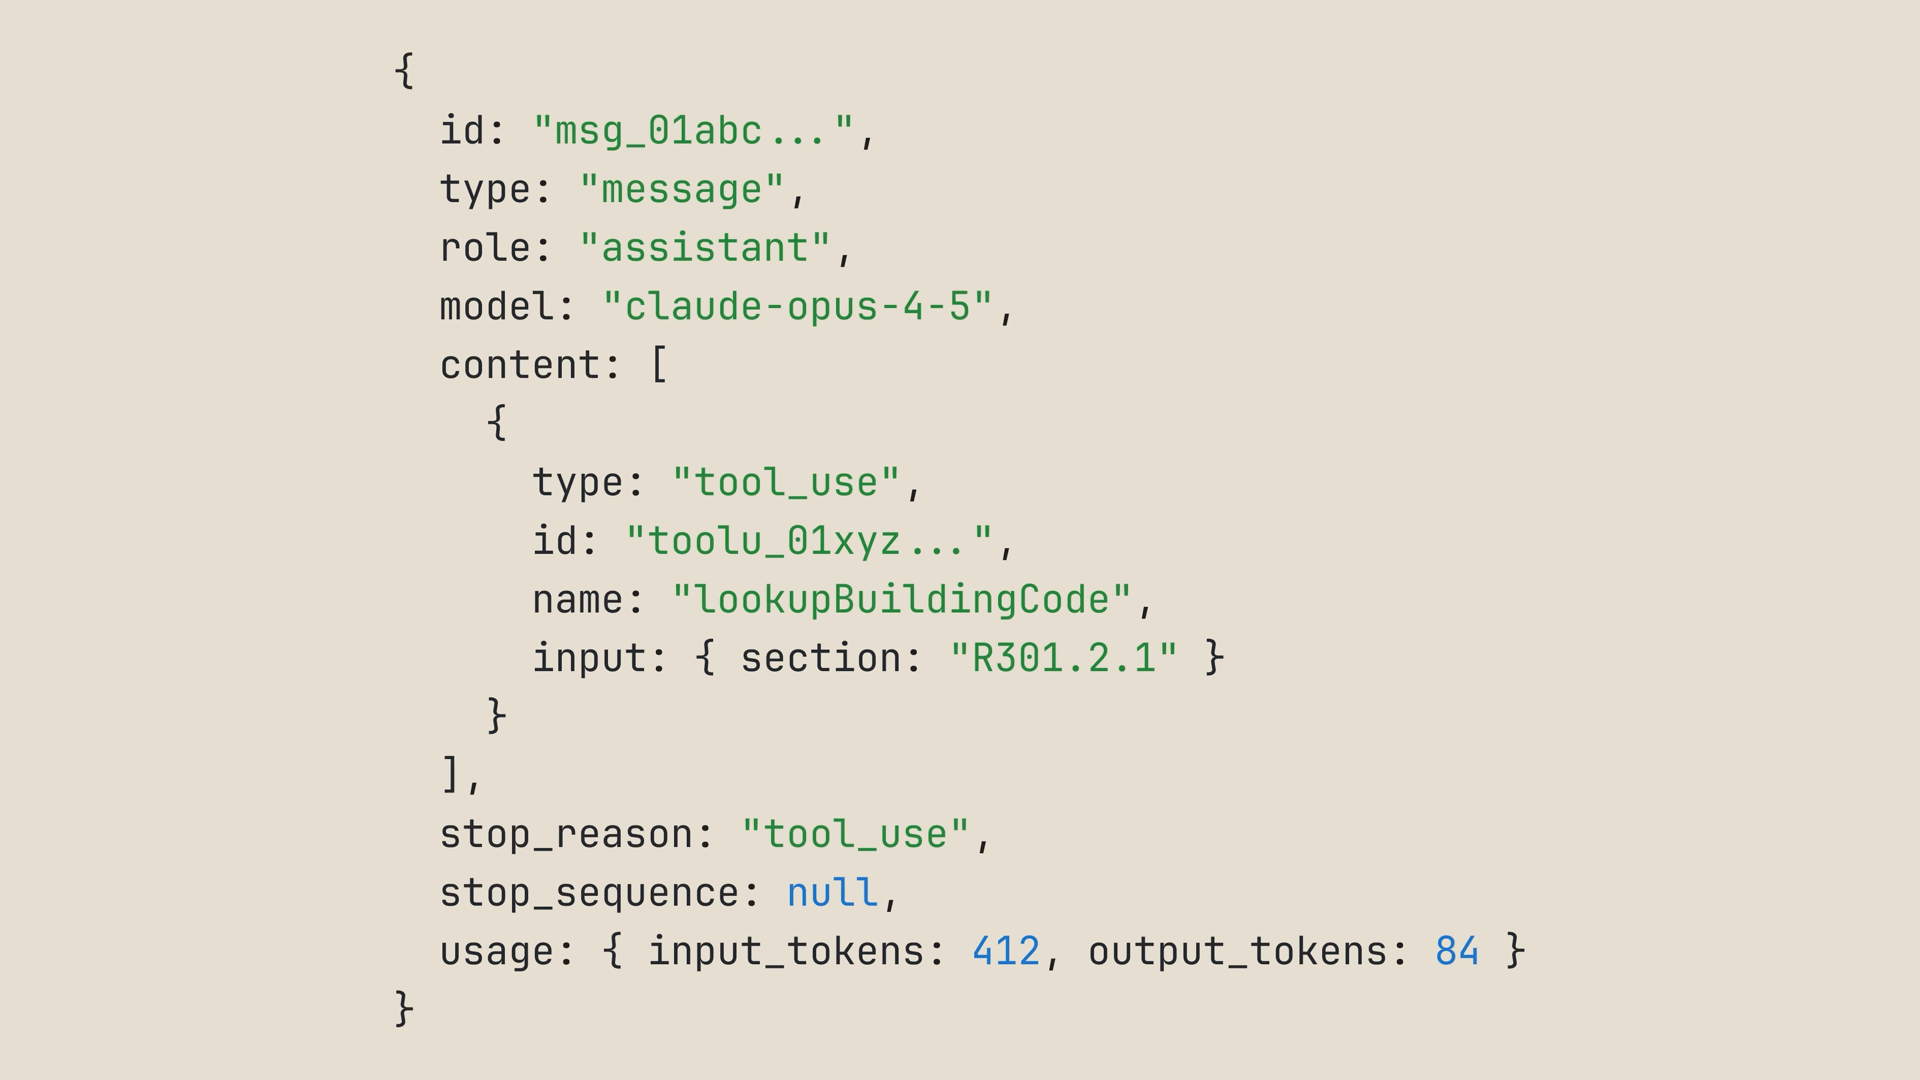
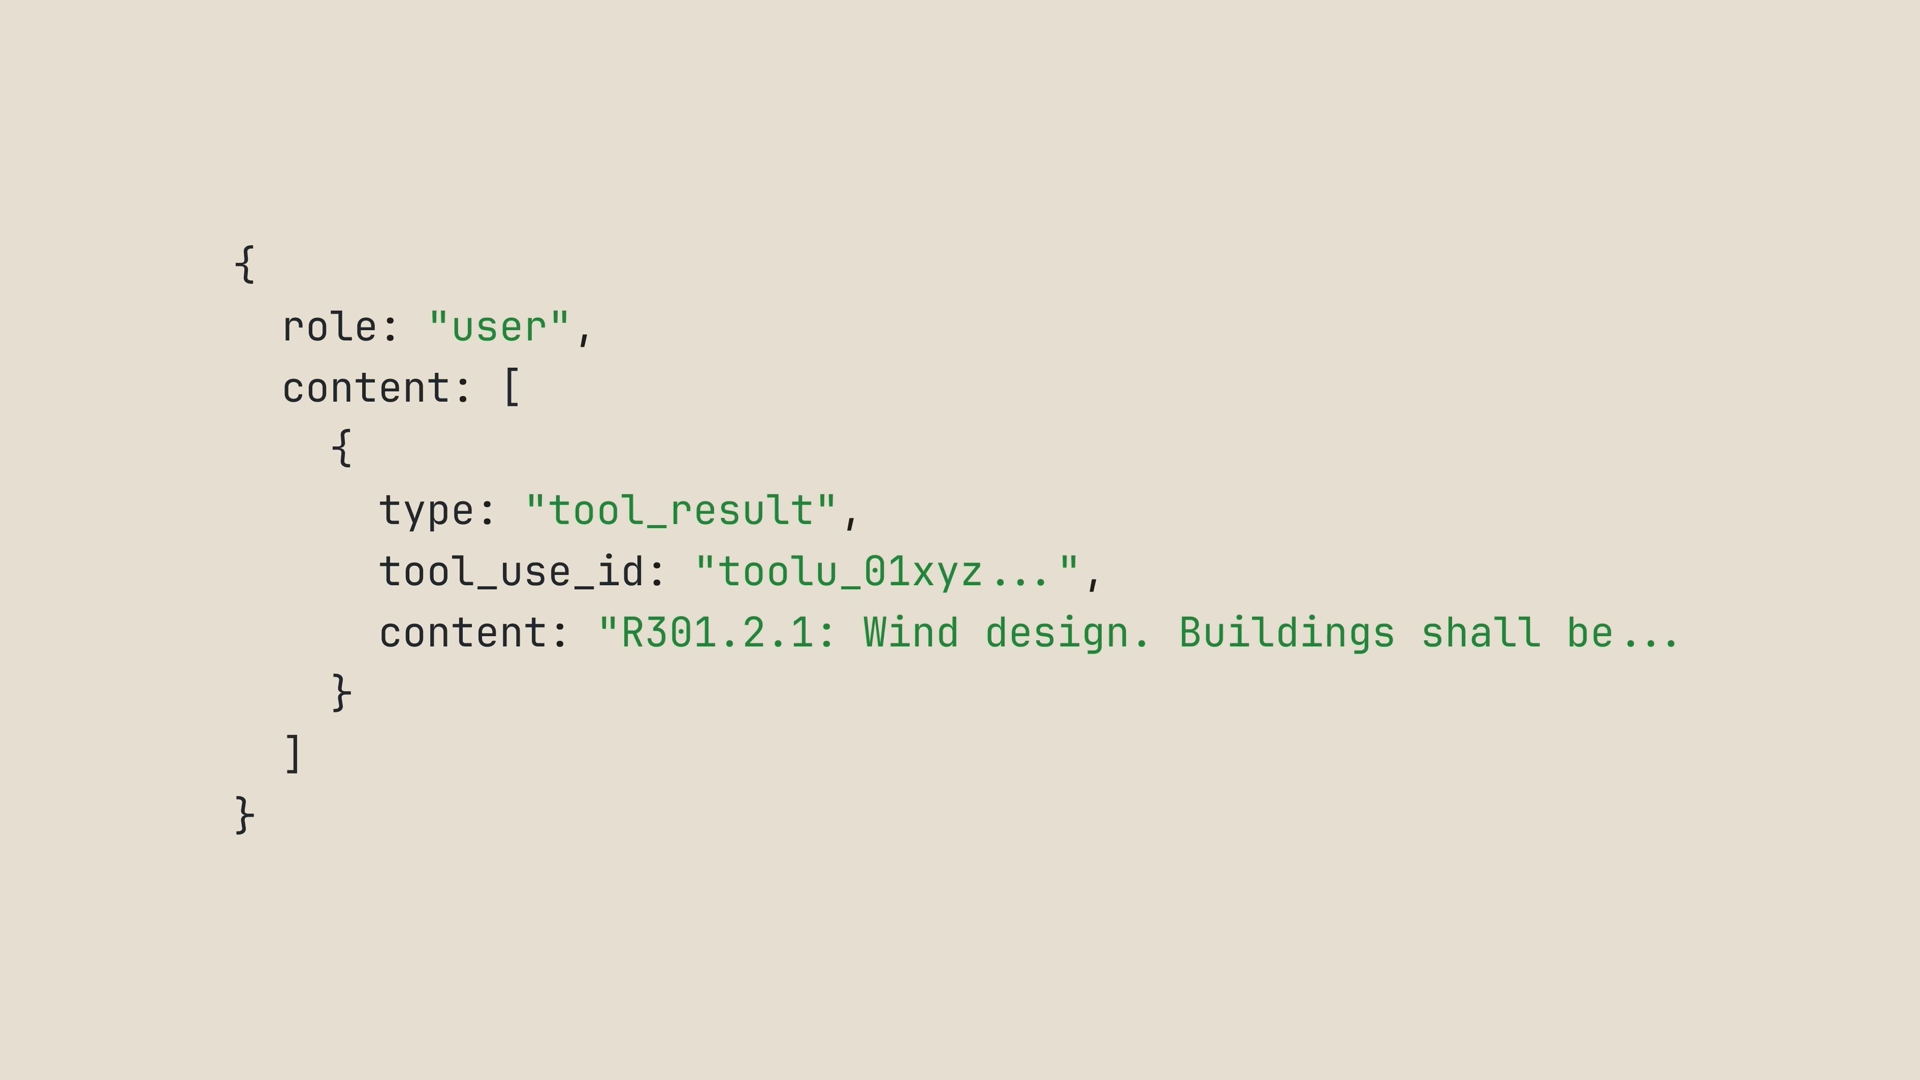
那么当我们使用这个时会发生什么?假设我们向代理人发送合规报告。第一个弯道,克劳德回stop_reason:“tool_use”——这是我们的信号。以下是这个回复的样子:
我们的循环调用了 Claude 请求的参数,然后将结果反馈为工具结果——包含与工具调用 id 绑定的块的用户消息:lookup_building_codetool_result
克劳德继续前行。到那时,我们可以不断调用工具并返回结果给Claude,直到它得到所需的数据。
多重工具:让克劳德自己挑选
一个工具很有用,但有趣的是给克劳德提供多个工具,并观察它选择使用哪个,顺序如何。
想象一下这样一个场景:你正在为一趟为期三天的丹佛之旅打包行李,想要今天的天气和接下来几天的天气预报。所以我们声明用两个工具而不是一个:
const tools = [
{
name: “get_weather”,
description: “Get today’s current weather for a city.”,
input_schema: {
type: “object”,
properties: {
city: { type: “string”, description: “The city to check” }
},
required: [“city”]
}
},
{
name: “get_forecast”,
description: “Get the weather forecast for the next few days for a city.”,
input_schema: {
type: “object”,
properties: {
city: { type: “string”, description: “The city to check” }
},
required: [“city”]
}
}
];
这个循环和我们之前见过的代理循环是完全相同的。唯一的新部分是一个函数,它通过 switch 语句调度工具名——这段代码块就是你的代码实际运行的地方:runTool
function runTool(name, input) {
switch (name) {
case “get_weather”:
return getWeather(input.city);
case “get_forecast”:
return getForecast(input.city);
}
}
while (true) {
const response = await client.messages.create({
model: “claude-sonnet-4-6”,
max_tokens: 1024,
messages,
tools,
});
if (response.stop_reason !== “tool_use”) {
// Claude is done — this is the final answer
break;
}
messages.push({ role: “assistant”, content: response.content });
const toolResults = response.content
.filter((block) => block.type === “tool_use”)
.map((block) => ({
type: “tool_result”,
tool_use_id: block.id,
content: runTool(block.name, block.input),
}));
messages.push({ role: “user”, content: toolResults });
}
这就是整个模式。想要第三个工具吗?把它加到数组里,给交换机加一个外壳,就完成了。
运行这个,你会看到克劳德叫——有时在同一回合,有时一个接一个。然后它回答:多包包,今天预计会有雪花飘落,一周内会逐渐变暖。get_weatherget_forecast
现在注意克劳德是如何选择的。它读取了描述,将你的提示映射到“今天的天气”和“接下来的几天”,并为每个主题选择了合适的工具。这就是为什么你的工具描述非常重要。
工具跑者:跳过模板
你可能已经注意到我们刚才写的内容有两个警示信号:
两个简单的查找就有这么多代码。
在真实的代码库中,你不会想为每个函数都手写JSON模式。这就像写了两次代码。
这就是工具跑腿的用武之地。它自带了 TypeScript、Python 和 Ruby 的 Claude SDK。运行者会接收你的实际函数,阅读类型和文档来构建模式,并内部处理整个工具使用/工具结果循环。
你的代码缩减到:描述工具、发送提示、等待结果。这是通过工具跑车接线的同样双工具天气演示:
// The same two lookups we ran by hand — just plain TypeScript functions
function getWeather(city: string) {
// …existing lookup
}
function getForecast(city: string) {
// …existing lookup
}
const runner = client.beta.messages.toolRunner({
model: “claude-sonnet-4-6”,
max_tokens: 1024,
messages: [
{
role: “user”,
content:
“I’m packing for a three-day trip to Denver. What’s the weather today and over the next few days?”,
},
],
tools: [getWeather, getForecast],
});
// Returns the final assistant message after all the tool ping-pong has settled
const finalMessage = await runner.untilDone();
同样的情况,代码的一部分:
没有while循环,没有停止理由切换,也没有手动将工具结果推回消息——这些都是运行者负责。
没有JSON模式,这样就不用重复写东西。
这两个函数和我们刚才手动运行的查找一样,只是用 TypeScript。
runner.untilDone()一切稳定后返回最后的助理消息。
运行它,答案是一样的。
真正的工具会包裹你现有的代码
现实中,你的工具不会是硬编码的天气数据。它们会包裹你应用中已有的实际函数。
以合规审核代理为例:它的工具是包覆代码库中已有功能的薄包装。使用工具运行器时,你可以直接传递这些函数,代理在每个查找中都会引用具体的代码部分——无需写入模式:lookup_building_codesearch_building_code
回顾
工具让Claude能够访问你的系统。工具是你定义并展示的一个函数;Claude 决定何时调用,你的代码执行。
工具是带有名称、描述和输入模式的JSON模式,作为数组通过请求传递。tools
写下具体的描述。模糊的描述是特工误职的头号原因。
stop_reason: “tool_use”是你运行工具并将结果反馈为工具结果的信号。
对于多个工具,可以根据工具名称来调度。添加工具意味着向数组添加并添加一个案例。
SDK的工具运行工具(TypeScript、Python、Ruby)会从你的实际函数构建模式,并处理整个循环——或者你也可以自己运行这个循环。
你执行循环,或者委派环路。在这个光谱的极端,管理代理会把整个代理委托给Anthropic。
你在想什么?
视频
你在想什么?
有些任务需要的不仅仅是快速的回答。Claude可以在回答前先解决问题——这叫做扩展思维。在本课中,我们将探讨什么是思考,如何激发思考,以及它何时真正有效。
这就是我们试图避免的失败模式。向模型提出一个多步骤问题,它能立即回答,它可能会自信地答错:
什么是扩展思维?
扩展思考让克劳德一步步推理,最终做出回应。启用后,Claude会生成内部推理代币——通常称为思维链——然后给出答案。理由并不隐藏:你可以在回复和最终文本旁边看到。
对作品4.7的适应性思维
而Opus 4.7则是灵活的思考。你不能随便挑一个象征性的预算。你只需打开它,克劳德会动态决定何时思考、思考多少。
要控制克劳德思考的程度,可以使用努力参数。一个小问题:它要放进去,而不是放在方块旁边。关卡如下:output_configthinking
low
medium
high(默认)
xhigh(超高)
max
什么时候用(什么时候跳过)
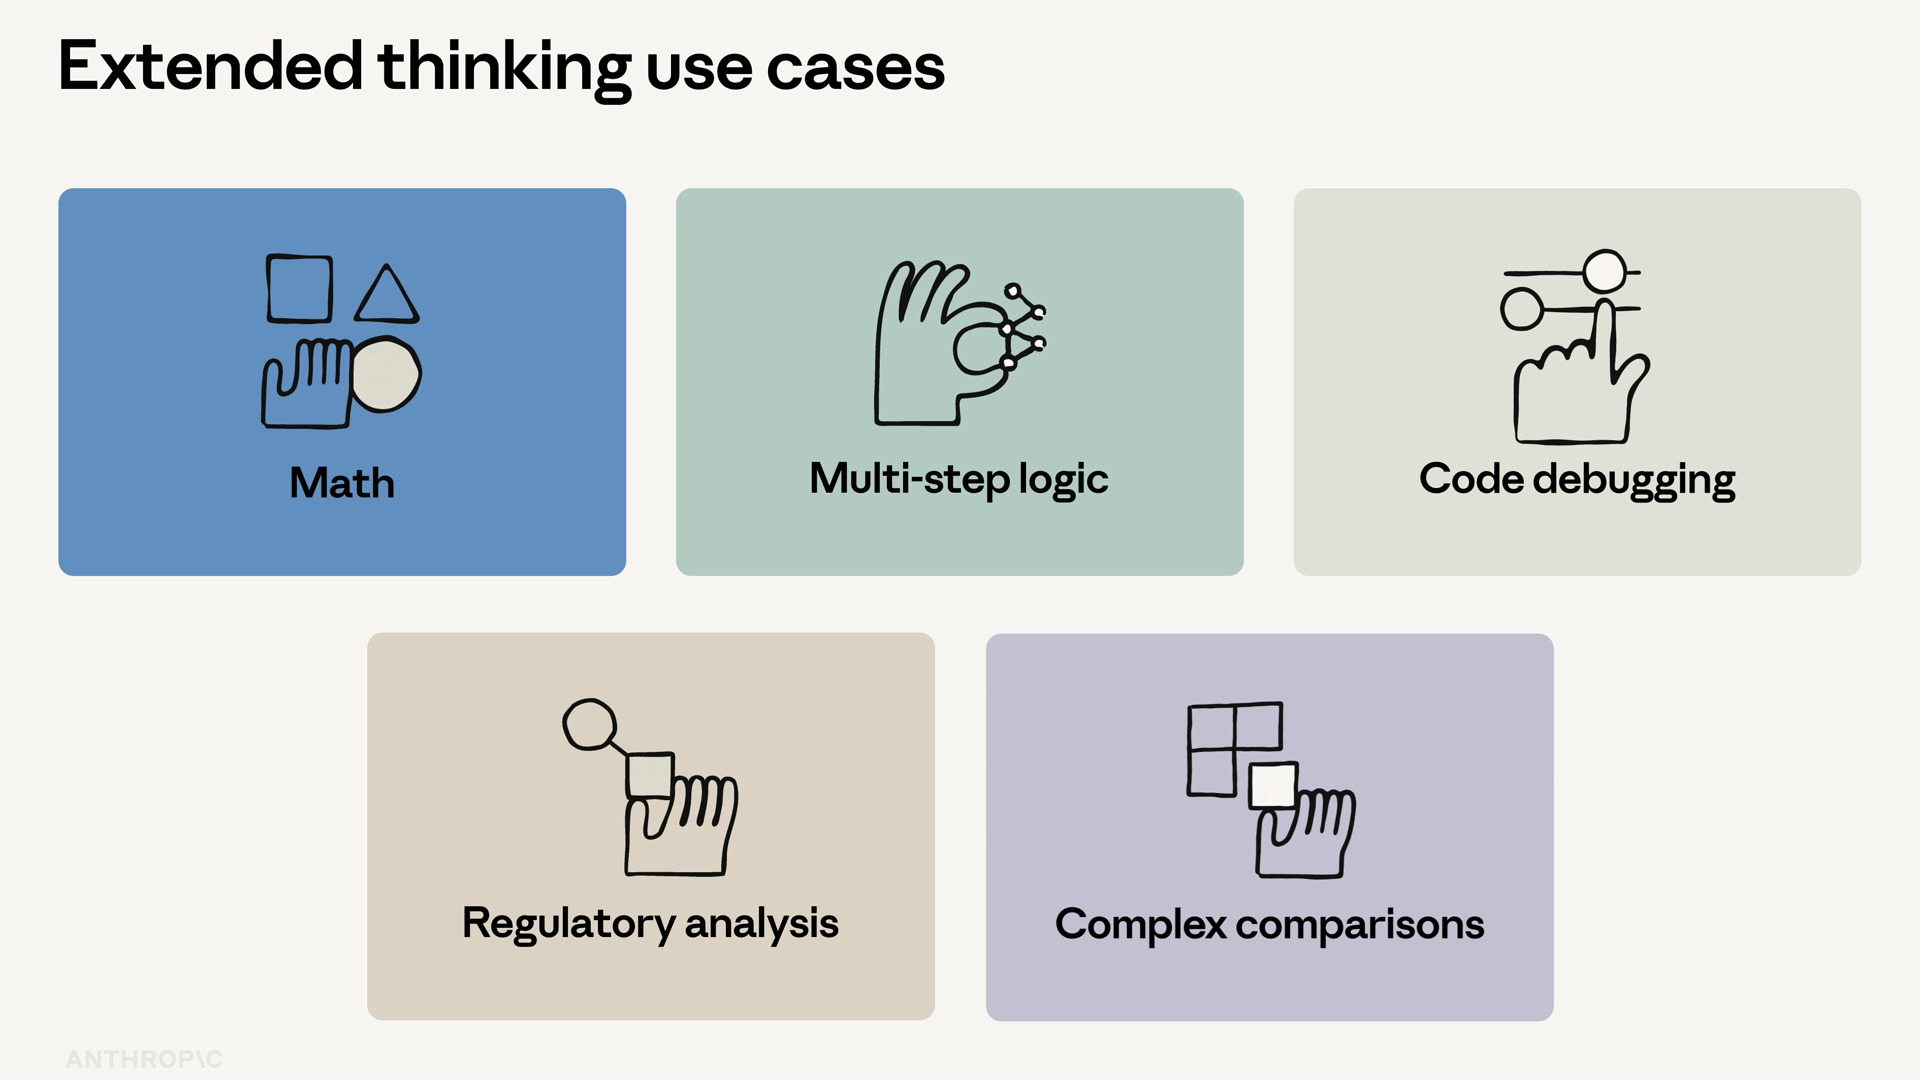
延伸思考有助于:
数学与多步逻辑
代码调试
监管分析
任何涉及权衡或比较选项的事情
跳过它,做简单的分类、提取或模板化。对于这些任务,它只是增加了延迟和成本,却没有真正改善结果。
行动中的思考
让我们看看它能不能用。这里有一个带一个天气工具的代理环,我们会请克劳德规划一次从旧金山出发的公路旅行——两站,权衡天气和驾车时间。这是一个真正的权衡,是思考才值得被关心的问题。
import anthropic
client = anthropic.Anthropic()
weather_tool = {
“name”: “get_weather”,
“description”: “Get the current weather for a city.”,
“input_schema”: {
“type”: “object”,
“properties”: {
“city”: {“type”: “string”, “description”: “City name”}
},
“required”: [“city”],
},
}
response = client.messages.create(
model=“claude-opus-4-7”,
max_tokens=16000,
thinking={“type”: “adaptive”},
output_config={“effort”: “high”}, # low | medium | high | xhigh | max
tools=[weather_tool],
messages=[
{
“role”: “user”,
“content”: “Plan a road trip out of San Francisco with two stops, “
“weighing weather and drive time.”,
}
],
)
运行这个过程时,输出比平时更有趣。你会看到Claude在思考区块中分析权衡,接着是工具调用来检查每个城市,最后是带有实际建议的文本块。
理由显而易见——这正是重点所在。
为什么这在生产中很重要
在生产应用中,这就是一个发现问题的代理和连接问题的代理之间的区别。以合规审核应用为例:在自动审核通话中切换适应性思维,可以让代理跨报告部分推理——发现第三部分的风载规范与文件其他部分材料规格冲突的情况。
回顾
扩展思考给了克劳德推理的空间,而他的回答中也能看出推理。
Opus 4.7 开启时——无需代币预算;克劳德决定何时思考,思考多少。thinking: {“type”: “adaptive”}
用努力参数拨号深度:, , (默认), , , 。output_configlowmediumhighxhighmax
用它来处理难题、权衡大的问题。简单的事情可以跳过——那边只会消耗延迟和代币。
内置工具
视频
内置工具
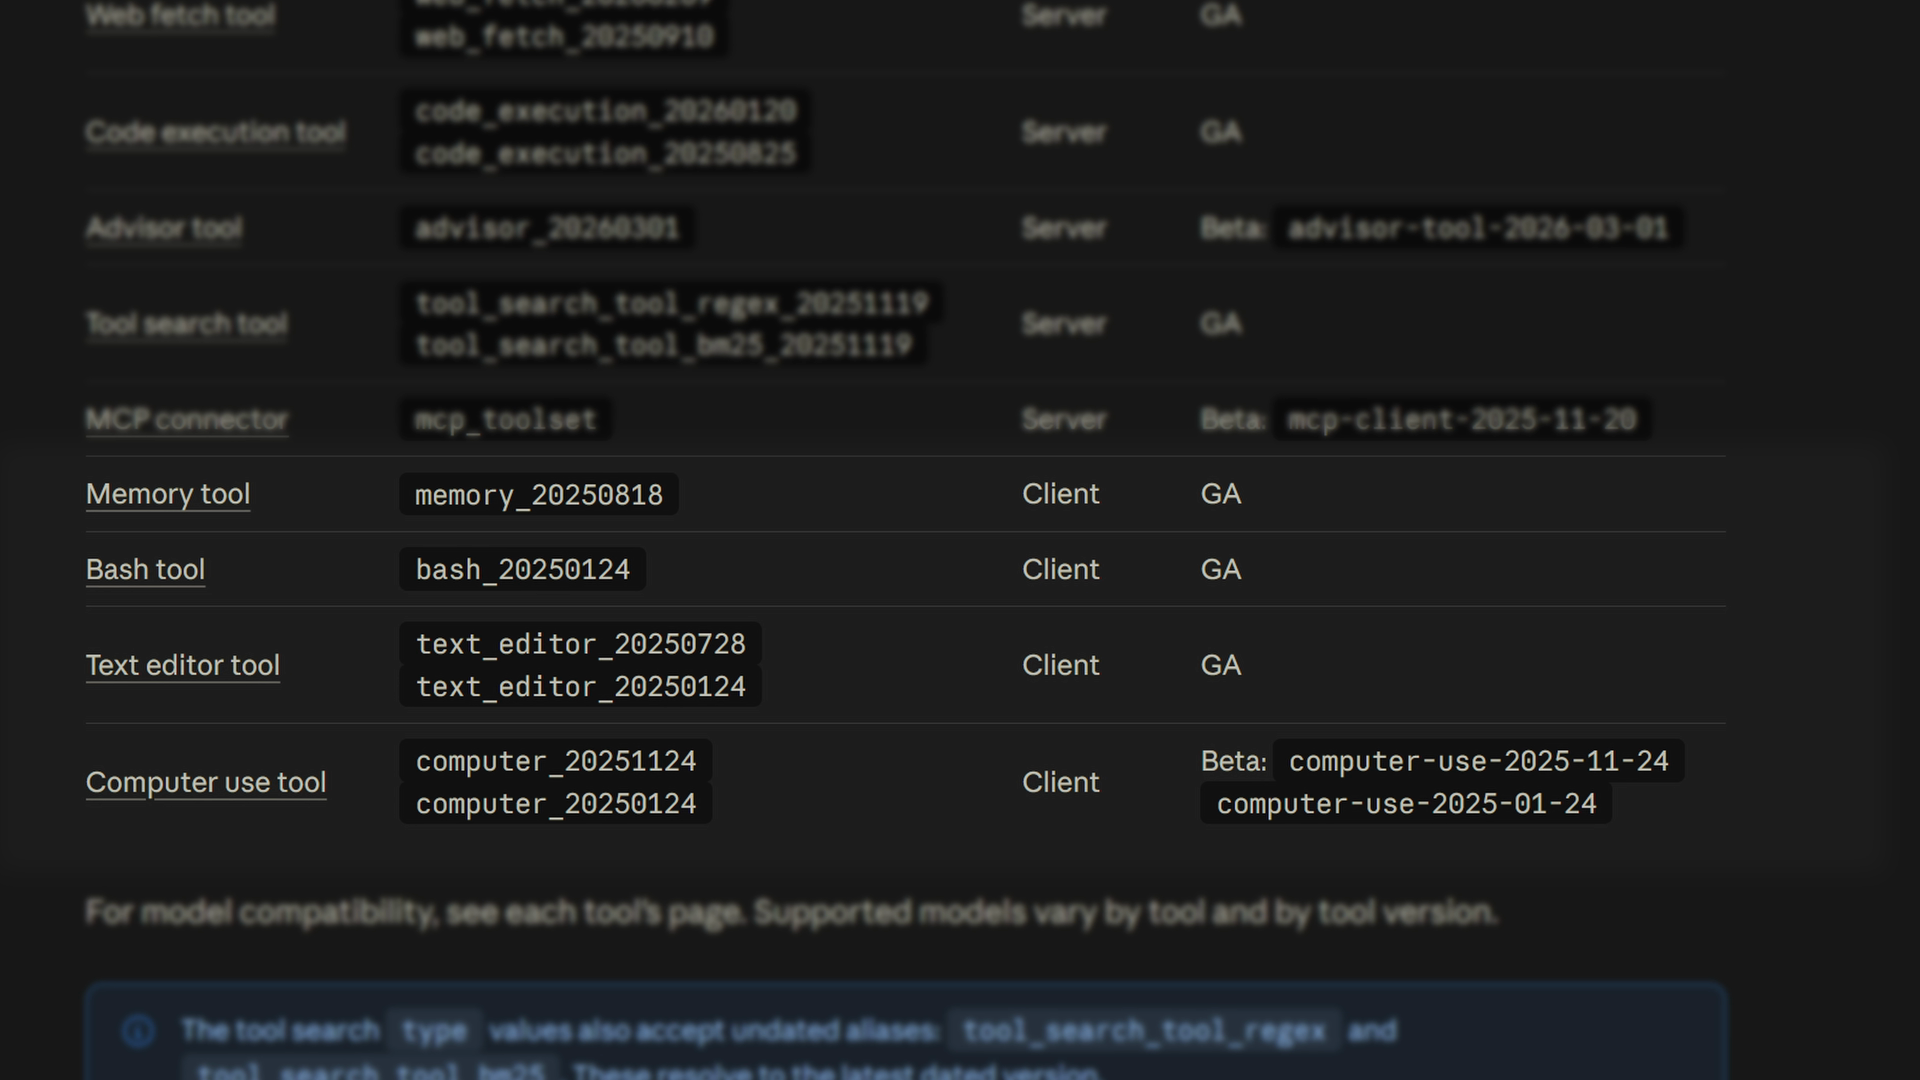
你可以自己定制工具,但有些功能足够普遍,Anthropic会预装成品。你不写代码。你不托管沙盒。你只需声明工具,Anthropic 就运行它。
服务器工具:由你声明,由Anthropic运营
Anthropic 提供运行在其基础设施上的服务器工具。这些不是你执行的——Anthropic 会执行。这意味着你不需要代理环路来处理这些电话。Claude 自己调用工具,结果也出现在相同的响应中。
主要的有:
网络搜索——通过互联网搜索并返回带有引用的结果
代码执行——在沙箱中编写和运行 Python
网页抓取——从 URL 获取完整内容
两个服务器工具在一个文件中
让我们来看看一个文件中的一些重要调用:两个调用,一个是网页搜索,一个是代码执行。messages.create
import anthropic
client = anthropic.Anthropic()
Call 1: web search — Anthropic runs the search server-side
search_response = client.messages.create(
model=“claude-opus-4-8”,
max_tokens=1024,
tools=[{“type”: “web_search_20260209”, “name”: “web_search”}],
messages=[
{“role”: “user”, “content”: “What is Anthropic’s latest model release? Answer in one sentence.”}
],
)
for block in search_response.content:
if block.type == “server_tool_use”:
print(f“Tool call: {block.name} — {block.input}”)
elif block.type == “text”:
print(block.text)
Call 2: code execution — Claude writes and runs Python in a sandbox
code_response = client.messages.create(
model=“claude-opus-4-8”,
max_tokens=1024,
tools=[{“type”: “code_execution_20260120”, “name”: “code_execution”}],
messages=[
{“role”: “user”, “content”: “Calculate the mean and standard deviation of [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]”}
],
)
for block in code_response.content:
if block.type == “server_tool_use”:
print(f“Tool call: {block.name} — {block.input}”)
elif block.type == “bash_code_execution_tool_result”:
print(f“stdout: {block.content.stdout}”)
elif block.type == “text”:
print(block.text)
有两点需要注意:
这里没有特工循环。我们不开机。我们不会把工具的结果推回去。Anthropic 在服务器端运行该工具,响应中已经包含了结果。stop_reason
响应有新的块类型。一个用于工具调用的块,一个代码执行工具的结果块用于输出,再加上普通的块。server_tool_usetext
运行
在网页搜索中,你会看到Claude的工具调用,然后是关于最新型号发布的一句话回答,并折叠了搜索引用。
代码执行时,你会看到Claude写的实际Python、运行它的沙箱的标准文件,以及最终的文本回答。
我们根本不用启动搜索爬虫。我们没有运行Python沙盒。我们申报了两个工具,并且都免费获得了。
另一类:客户端工具
值得知道还有另一个类别。客户端工具运行在代码运行的地方。它们是用 Claude SDK 发布的,所以你不需要自己定义 schema。举两个例子:
内存——Claude 在会话间读写内存
Bash —— 一个持续的 bash shell,让 Claude 能够执行命令
它们的形状和自定义工具一样,但SDK给你提供了模式和一个合理的运行工具。
为什么这在生产中很重要
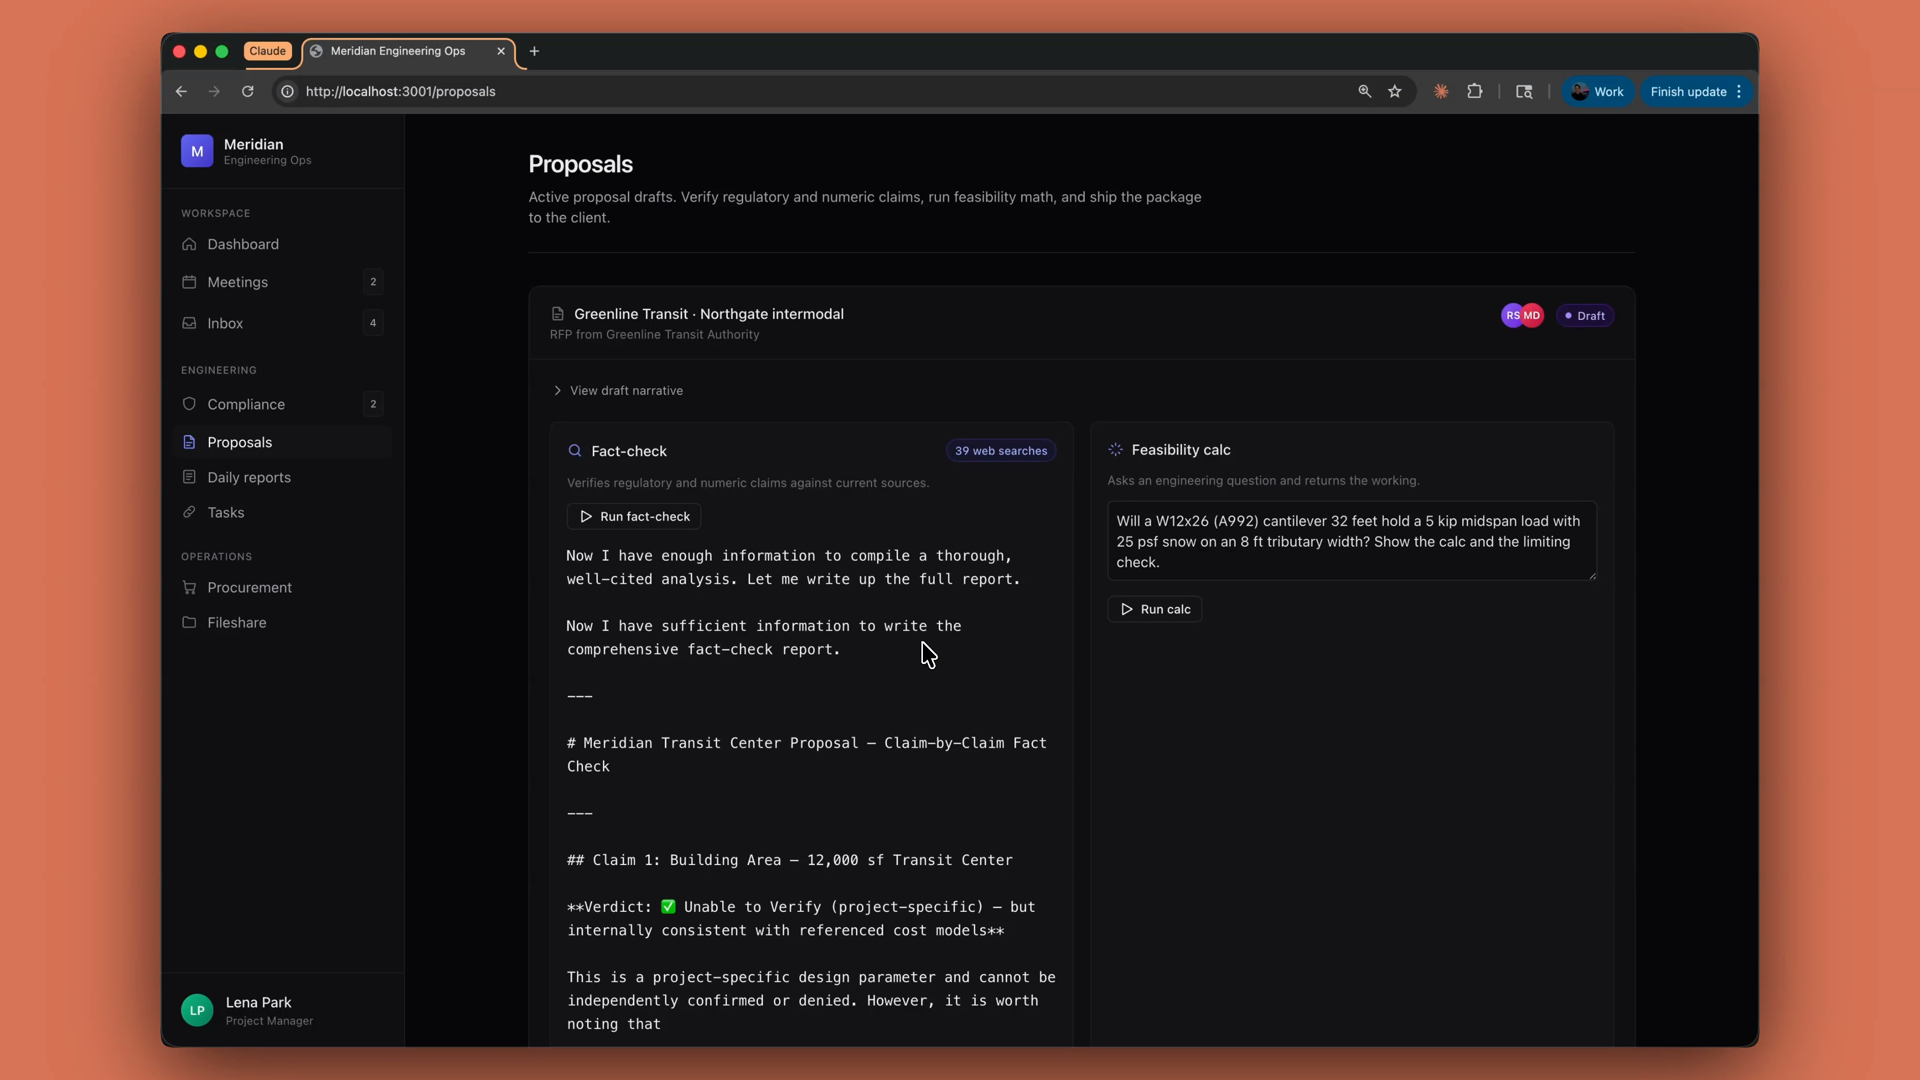
在生产应用中,这是获取功能的最短路径,否则需要数周时间。网络搜索可以支持事实核查终端,验证草稿中的每一个数字和监管声明,针对实时网络进行验证。
不过提醒一下:仅仅因为某件事在互联网上被验证,并不意味着它是真的。一定要仔细核对克劳德的工作。
回顾
服务器工具——网页搜索、代码执行、网页抓取——都在你的数组中声明。Anthropic负责运营。tools
你会得到相同的响应,无需代理循环。在普通文本块旁边寻找并工具搜索结果块。server_tool_use
客户端工具如内存和bash运行在代码运行的地方,但SDK会为你提供模式和运行程序。
“由Anthropic托管”的想法可以放大到最大:托管代理应用到整个代理,而不仅仅是一个工具。
Skills
Skills are folders of instructions, scripts, and resources that Claude loads dynamically to improve performance on specialized tasks. At the core of every Skill is a file — a packaged set of instructions you upload once and then attach to any call. You’re teaching Claude how you do something: your status report format, your review checklist, your release notes. Claude reads the Skill, follows the procedure, and produces output in your shape.SKILL.mdmessages.create
Skills vs. tools
It’s worth being clear on the difference, because the two solve different problems:
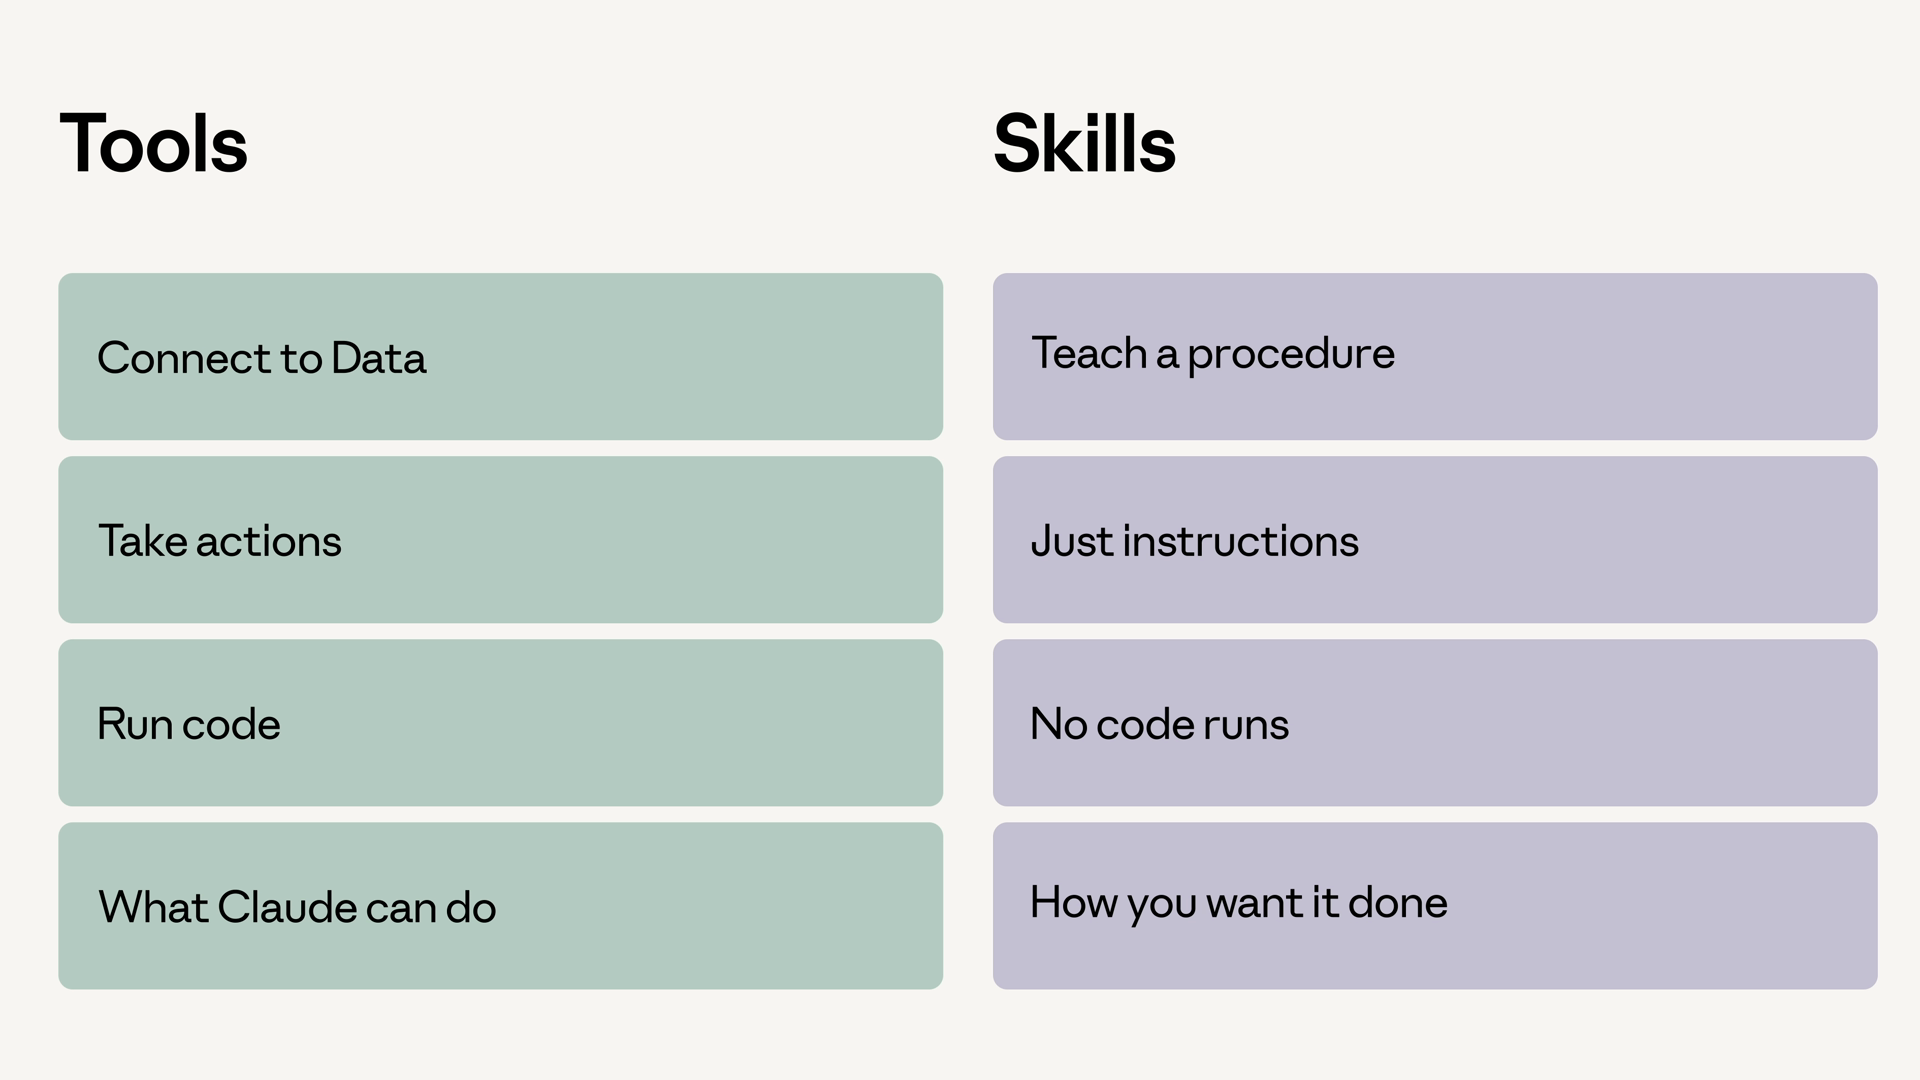
Tools connect Claude to data and actions. “Look up this code section,” “send this email” — Claude calls the tool, and something else runs.
Skills teach Claude a procedure. “Generate the daily status report following this template” — it’s a playbook Claude reads and follows, which sometimes means running bundled scripts itself.
A simple way to remember it: tools are about what Claude can do, while Skills are about how you want it done.
One more thing worth knowing: Skills don’t load fully into context on startup. Only the name and description load at first. When your agent decides a Skill is relevant, it then loads the full Skill into context. That keeps your context lean even when many Skills are available.
Uploading a Skill
Skills are uploaded once to your workspace, then referenced by ID. You can upload directly on the Claude Platform, or do it programmatically:
skill = client.beta.skills.create(
display_title=“Status Report Generator”,
files=files_from_dir(“status-report-skill”), # folder containing SKILL.md
)
print(skill.id) # reference this ID in future requests
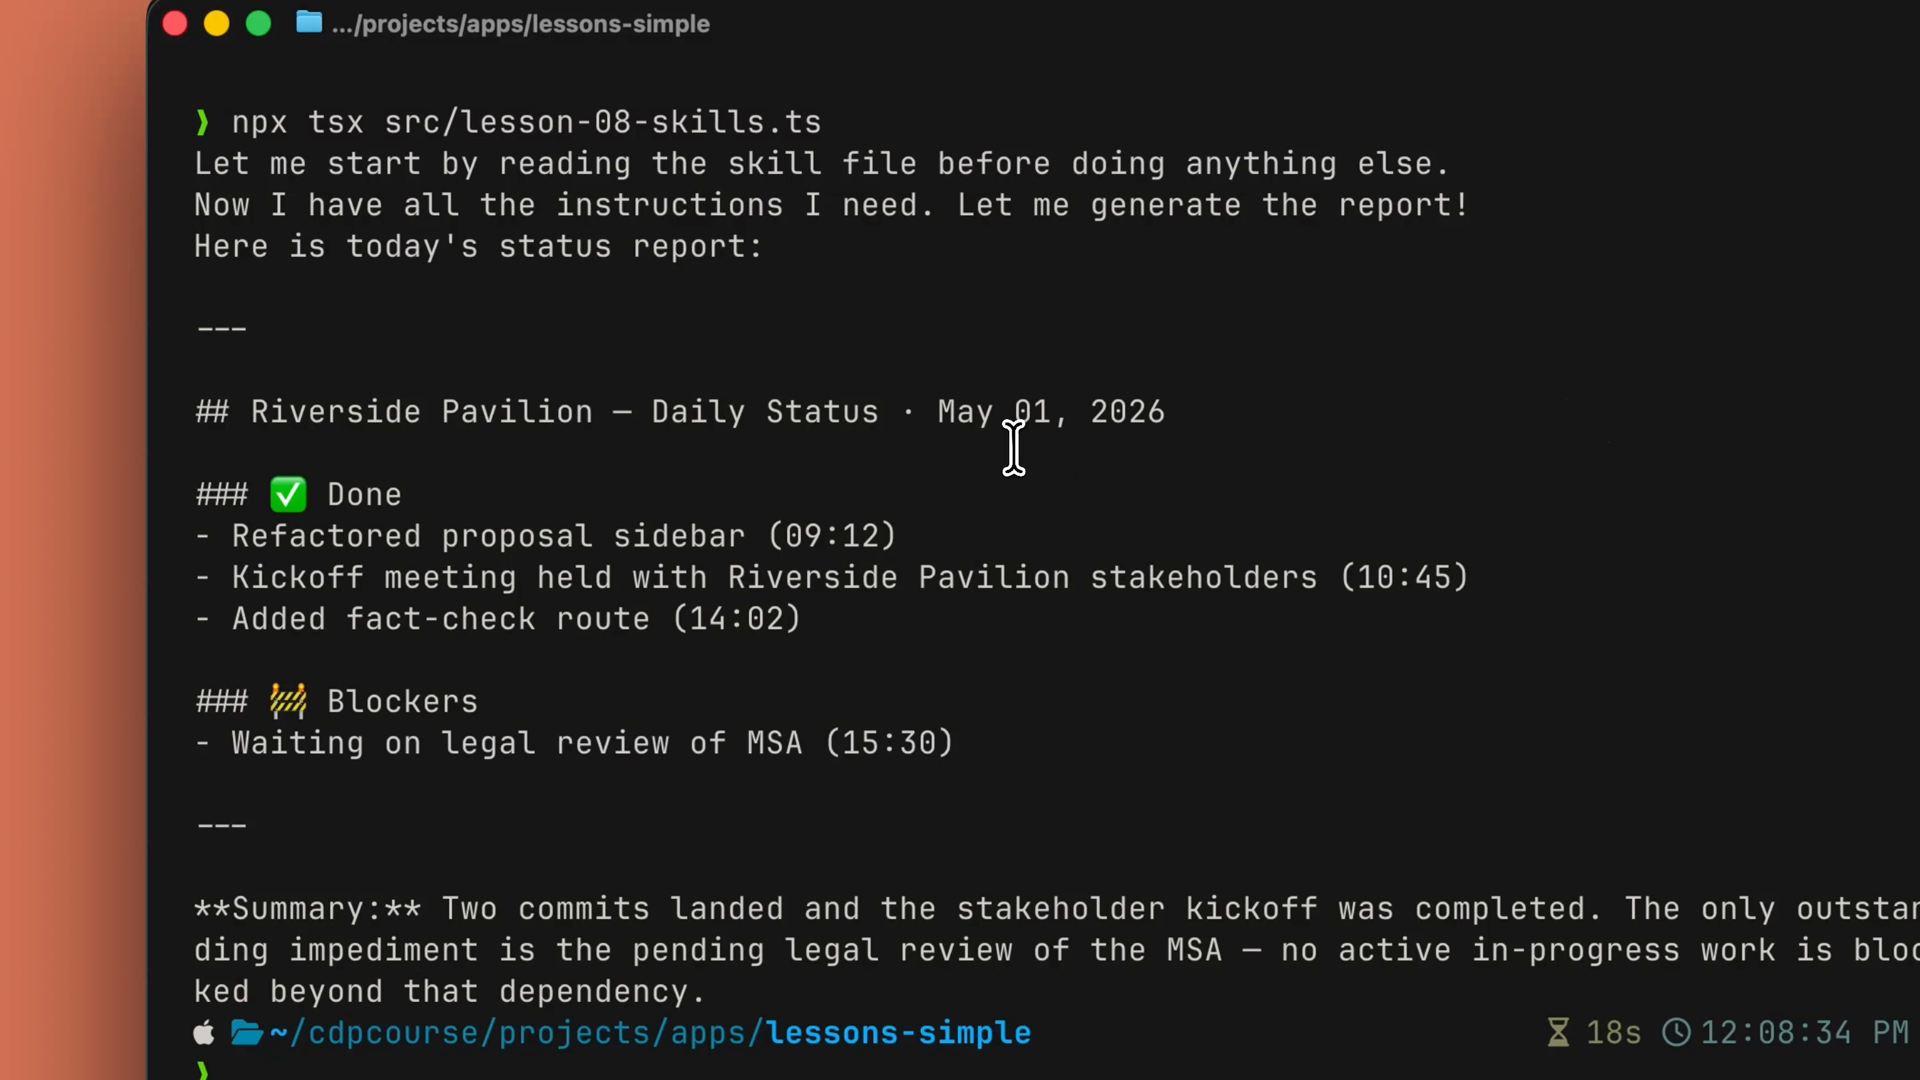
For this example, I want a status report generator. All the rules for what makes a good status report — sections, tone, how to summarize, how to handle blockers — live in a Skill packaged ahead of time. The activity log itself is just a string passed in at request time.
Attaching a Skill to a request
Skills attach to a request through the container configuration — a array inside the container, where each entry names a and . Here’s the full call for the status report generator:skillsskill_idversion
response = client.beta.messages.create(
model=“claude-sonnet-4-5”,
max_tokens=4096,
betas=[“skills-2025-10-02”, “code-execution-2025-08-25”],
container={
“skills”: [
{
“type”: “custom”,
“skill_id”: skill.id,
“version”: “latest”,
}
]
},
tools=[
{
“type”: “code_execution_20250825”,
“name”: “code_execution”,
}
],
messages=[
{
“role”: “user”,
“content”: f“Generate the daily status report from this activity log:\n\n{activity_log}”,
}
],
)
A few things worth pointing out:
We’re calling , not the standard one, and passing the skills feature via the beta header. As of this video, Skills are still a beta feature.client.beta.messages.create
container.skills is where the Skill attaches. It’s a list, so you can layer multiple Skills onto one call.
Code execution is turned on here too. Skills often pair well with code execution, because Skill procedures can do real work — like running scripts in a terminal.
Running it
The output is a status report formatted exactly the way the Skill says to format it. Sections, tone, blocker handling — all of it comes from the file you uploaded. The user prompt is one line; the procedure lives in the Skill.SKILL.md
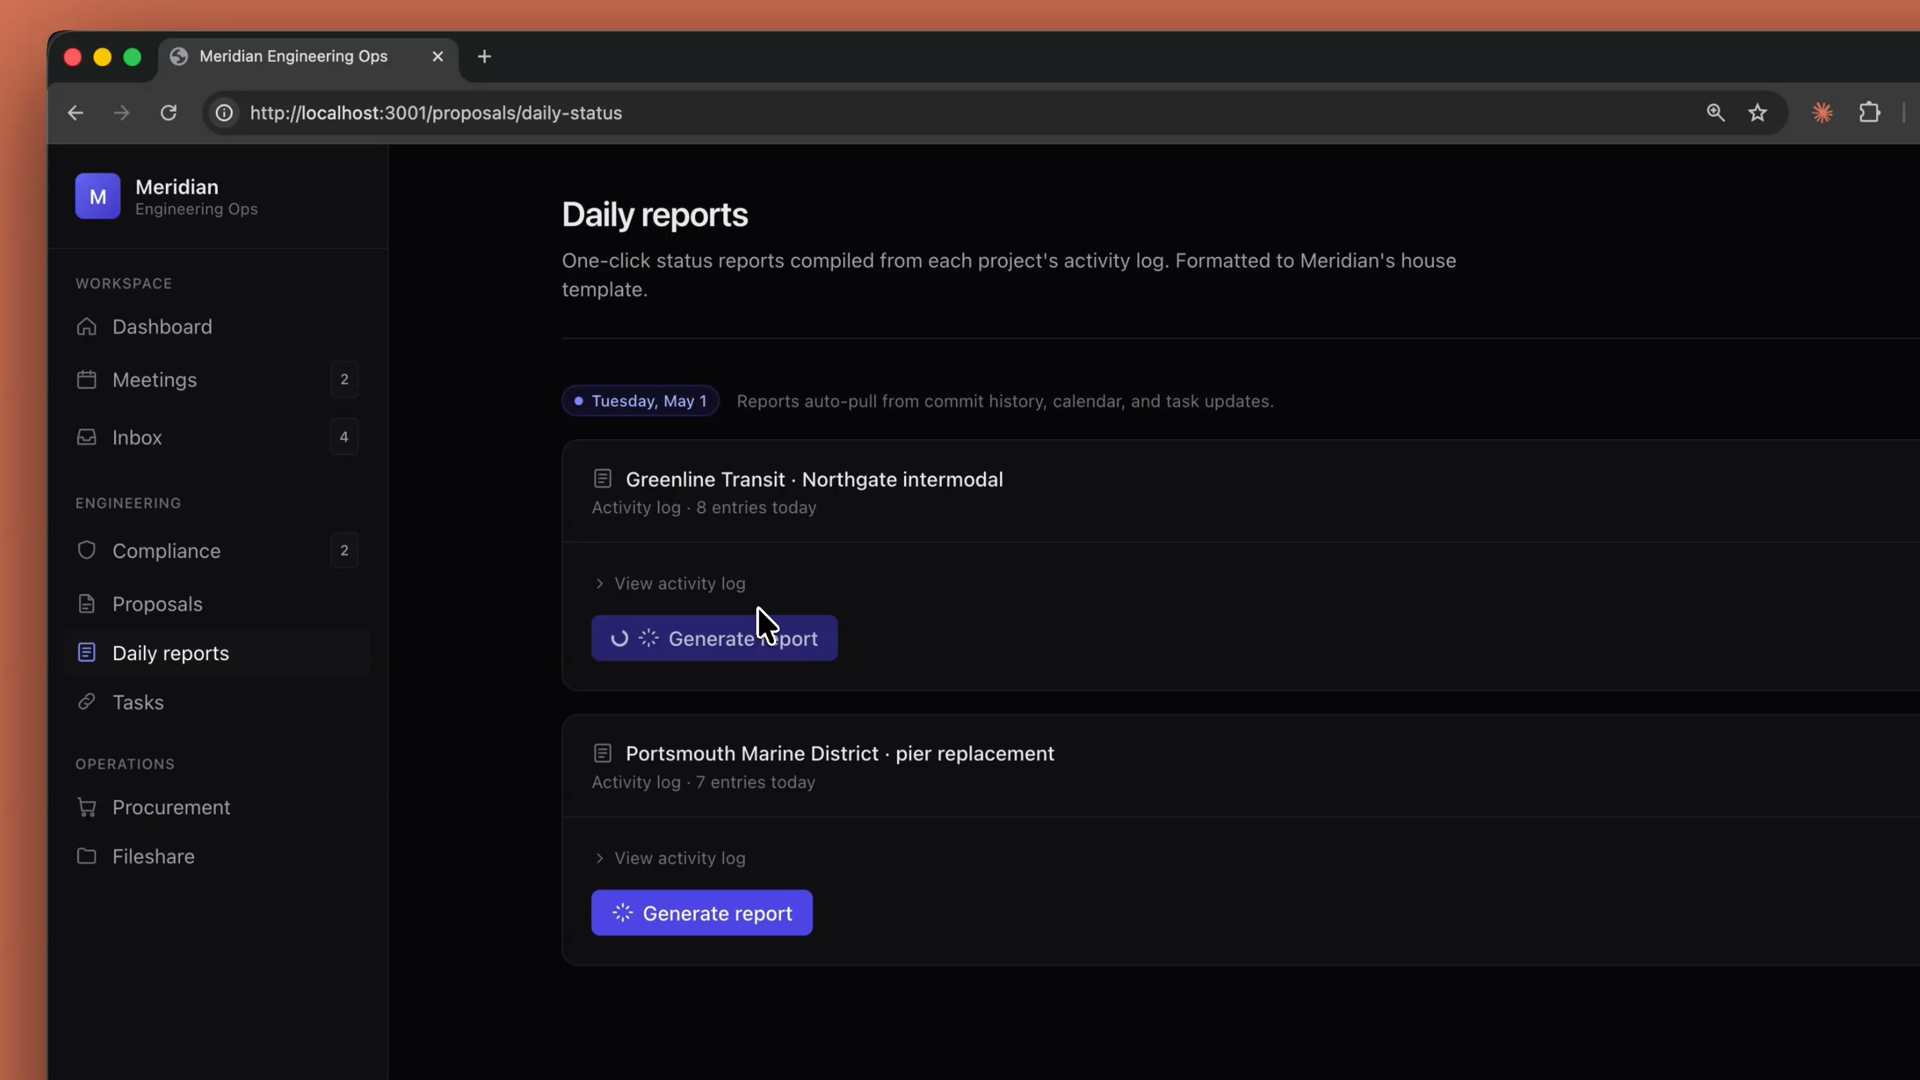
在生产应用中,团队就是这样在整个功能中标准化输出。有了这个每日状态报告终端,每个项目经理都能获得相同的结构、相同的语气、相同的部分、相同的顺序——无需有人复制模板到提示词中。
回顾
技能为你的程序打包。一个文件(加上任何脚本和资源)教会Claude你希望如何完成某件事。SKILL.md
工具与技能:工具关乎克劳德能做什么;技能是你想怎么做的。
技能是逐步加成的。启动时只有名称和描述加载;当特工决定使用技能时,完整技能会加载到上下文中。
上传一次,然后在任何通话中附加一个列表,这样你可以叠加多个技能。client.beta.skills.createcontainer.skillsmessages.create
当技能的过程需要真正工作时,配合代码执行。
当“怎么做”和“做什么”一样重要时,就去追求一项技能。
MCP
我们有工具、技能和连接者。那么MCP为什么存在?乍一看,它像是叠加在 API 上的第二个 API。这是个合理的问题——答案归结于谁维护集成代码。
维护问题
比如说你的客服需要一次性从 Asana 提取任务、查看 Google 日历和搜索 Slack。使用自定义工具时,你需要写三个集成。这部分是可以做到的。最痛苦的是:每当这些服务更改 API 时,你还得维护这些集成,这种情况经常发生。恭喜你,你现在正在维护一堆第三方API包装器。
MCP将维护转交给服务提供商。Asana发布了一个MCP服务器。Slack发布了一个。谷歌发布了其中一例。每个服务器都通过标准协议暴露自己的工具——包括描述、模式和认证。当他们的 API 变更时,他们会更新服务器。你什么都改变不了。
工具 vs. 技能 vs. MCP
这三个功能各有不同功能:
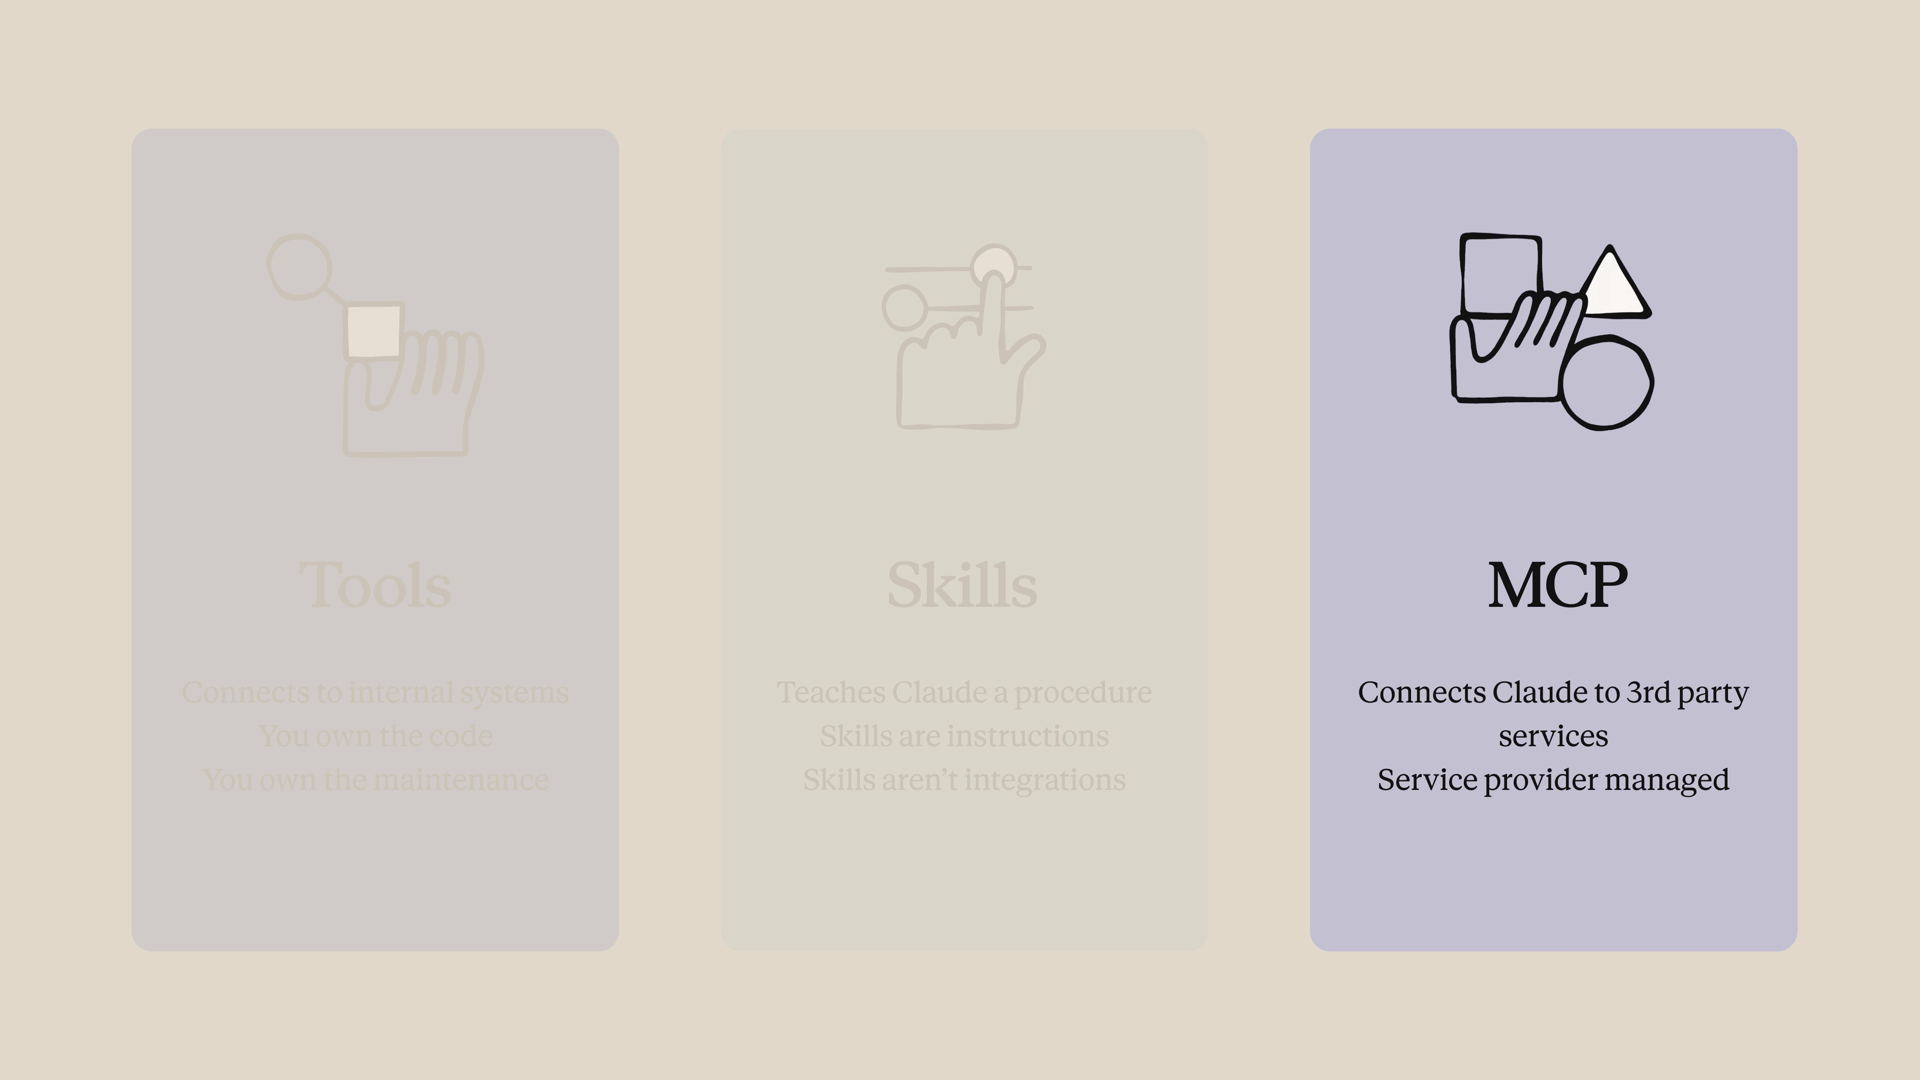
工具将Claude与您的内部系统连接起来——您的数据库、项目跟踪器、专有API。你拥有代码,所以你也拥有维护。
技能教会克劳德一个流程——你的报告模板,你的审查清单。技能是指令,不一定是整合。
MCP将Claude连接到第三方服务,服务提供商负责维护集成。你不是写Asana包装的——是Asana写的。
简而言之:工具是用来处理你的东西的,技能是用来处理流程的,MCP则是用来处理别人的东西。
连接到MCP服务器
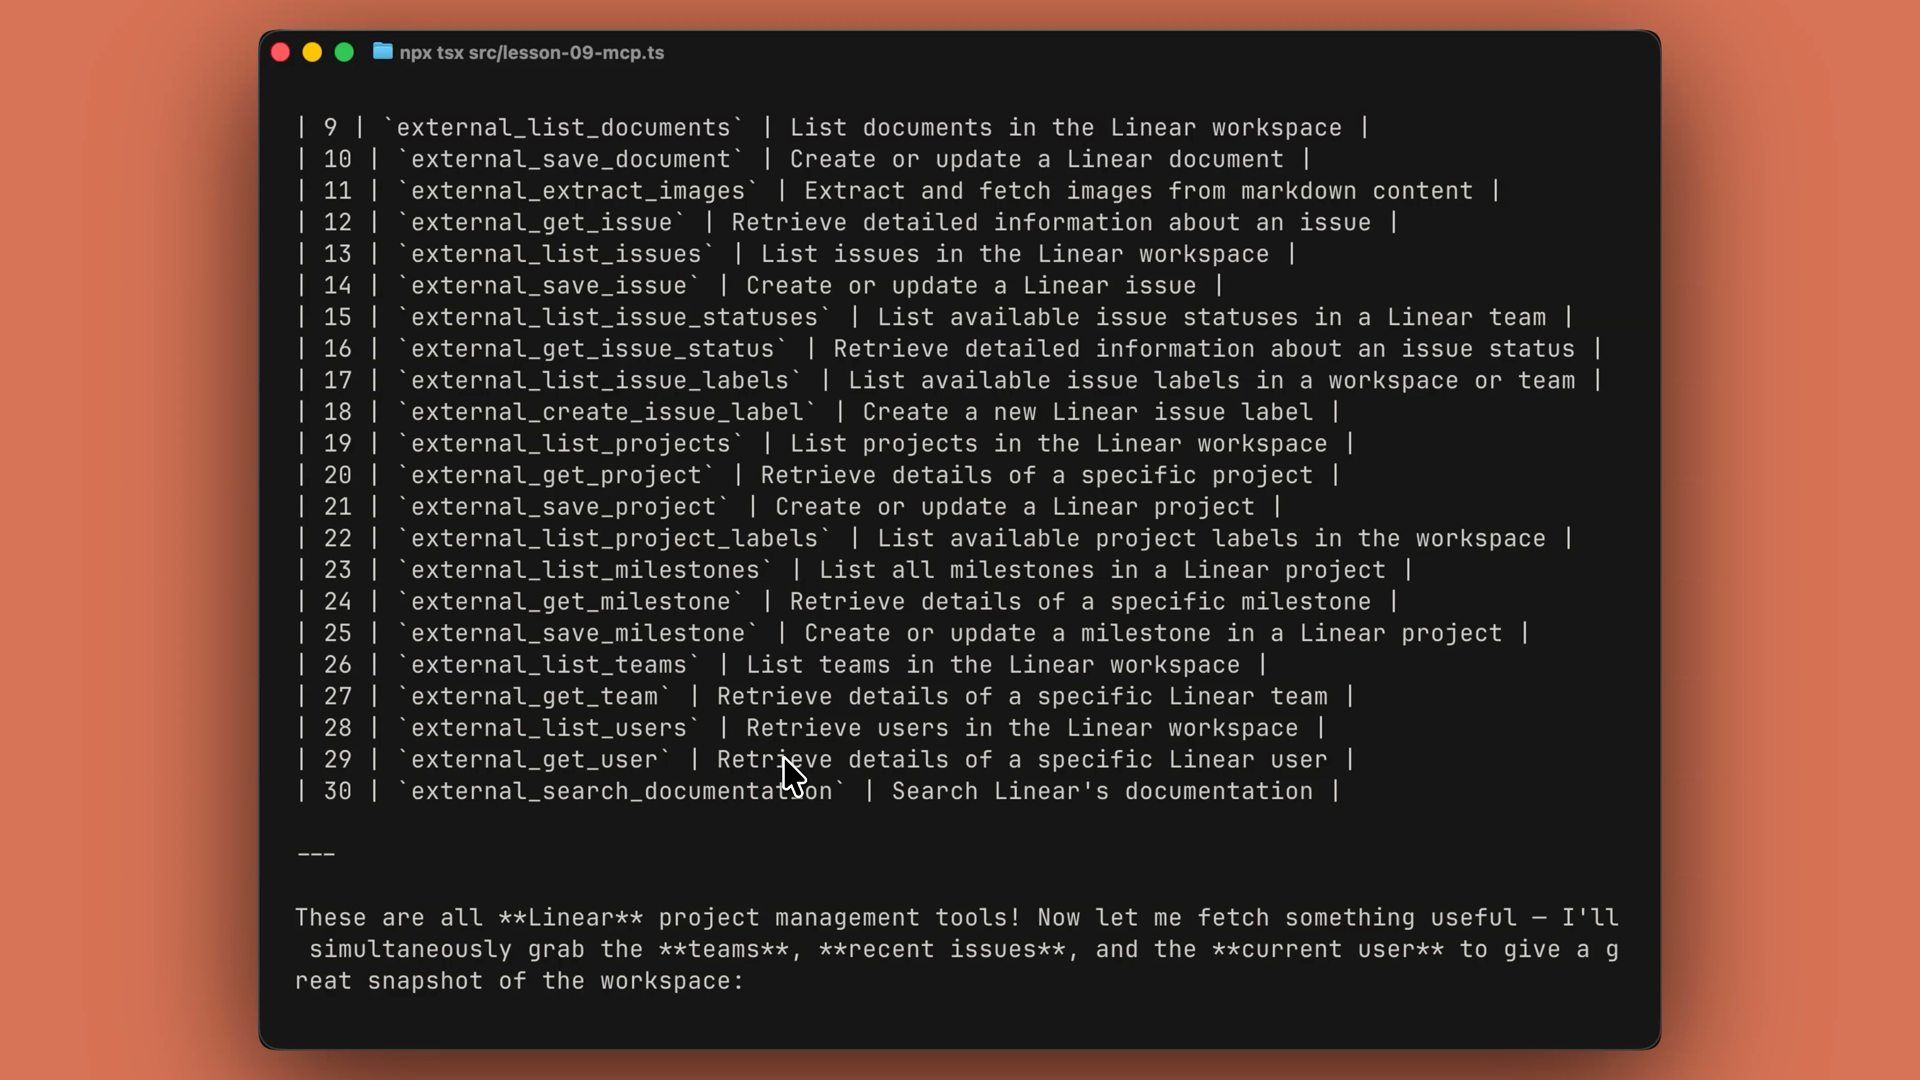
最直观了解MCP的方法是让Claude指向任意MCP服务器,让它自己发现其中的内容。在这个例子中,我们将使用线性MCP服务器,连接详情和认证令牌存储在文件中。.env
请求中有两个元素是协同工作的。密钥声明连接——一个类型、一个URL、一个用于引用它的名称,以及可选的认证令牌。然后用 该类型的工具配置 Claude 可以在该服务器上使用哪些工具。默认是全部,但如果你想缩小范围,这里就是你要做的地方。mcp_serversmcp_toolset
import os
import anthropic
client = anthropic.Anthropic()
response = client.beta.messages.create(
model=“claude-opus-4-8”,
max_tokens=1000,
messages=[
{“role”: “user”, “content”: “What tools do you have available?”}
],
mcp_servers=[
{
“type”: “url”,
“url”: “https://mcp.linear.app/mcp”,
“name”: “linear”,
“authorization_token”: os.environ[“LINEAR_MCP_TOKEN”],
}
],
tools=[
{
“type”: “mcp_toolset”,
“mcp_server_name”: “linear”,
}
],
betas=[“mcp-client-2025-11-20”],
)
print(response)
注意我们从未编写过单一的工具模式。克劳德反思服务器,拿回工具列表和它们的模式,并选定了提示所需的正确方案。截至本课,MCP连接器处于测试阶段——请注意请求中的beta头。
运行它,如果你的MCP网址指向Linear的MCP端点,Claude会列出Linear的工具,然后调用一个。基本上任何合规服务器都适用。我们没有定义任何一个工具。我们没有写线性客户端。线性正在维持这种状态。
筛选 Claude 可以使用的工具
MCP服务器经常暴露大量工具——你并不总希望Claude使用所有这些工具。也许你不想让它有写权限,或者你只是不想让所有这些工具定义占据上下文。
解决办法是:默认禁用所有工具,然后只启用你想要的特定工具。这是 Slack MCP 服务器的模式:
tools=[
{
“type”: “mcp_toolset”,
“mcp_server_name”: “slack”,
“default_config”: {
“enabled”: False,
},
“configs”: {
“search_messages”: {“enabled”: True},
“list_channels”: {“enabled”: True},
},
}
]
现在Claude可以搜索Slack并列出频道,但不能发布或删除。当你信任某个读取服务,但又不想让Claude无意中代你写作时,这非常有用。
回顾
MCP的存在是为了让你不用维护别人已经构建的集成。服务提供商发布一个MCP服务器并保持最新——API变动时你不会做任何更改。
选择合适的功能:数据工具、流程技能、第三方服务的MCP。
在 中声明连接(类型、URL、名称、可选认证令牌),并以 中的条目授予访问。Claude 自我反思,发现了工具——无需编写模式。mcp_serversmcp_toolsettools
通过设置和启用特定工具来缩小访问权限——这对保持服务器只读很方便。default_config: {“enabled”: False}configs
MCP连接器目前处于测试阶段,请在请求中包含测试版头。
请访问 modelcontextprotocol.io 查看可用服务器列表及了解更多协议信息。
上下文管理
你发送给Claude的每个请求都有一个上下文窗口。一百万代币听起来很多,但一旦你开始发真正的经纪人,代币用得比你想象的快。这就是情境管理的作用:你如何保持在窗口内而不失去重要的东西。
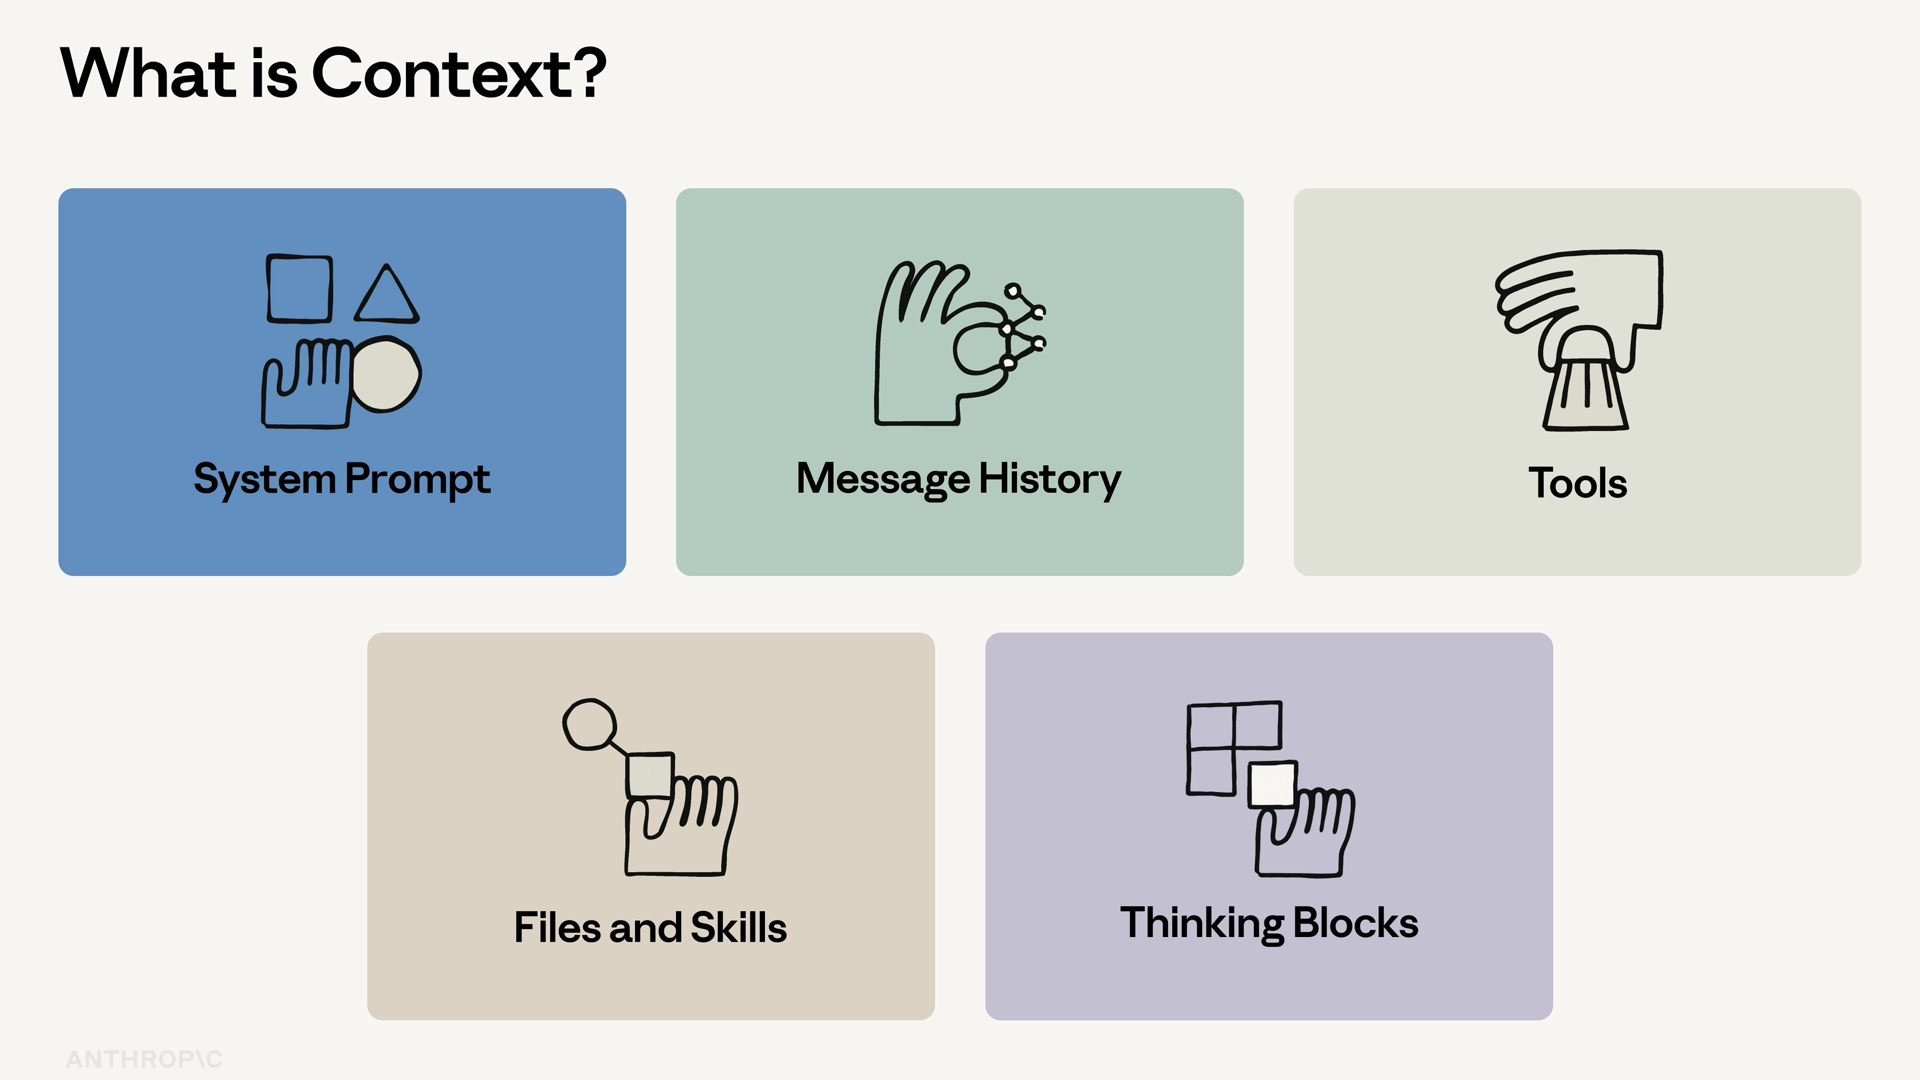
什么算作背景
上下文是克劳德在某回合看到的一切:
系统提示
消息历史
工具定义与工具结果
附件文件与技能
思维障碍
它是每一个API调用的输入。进门时付钱,出门时付钱。一旦窗口满了,请求就失败了。
所以目标不是把所有东西都塞进去。目标是把合适的内容融入进去。
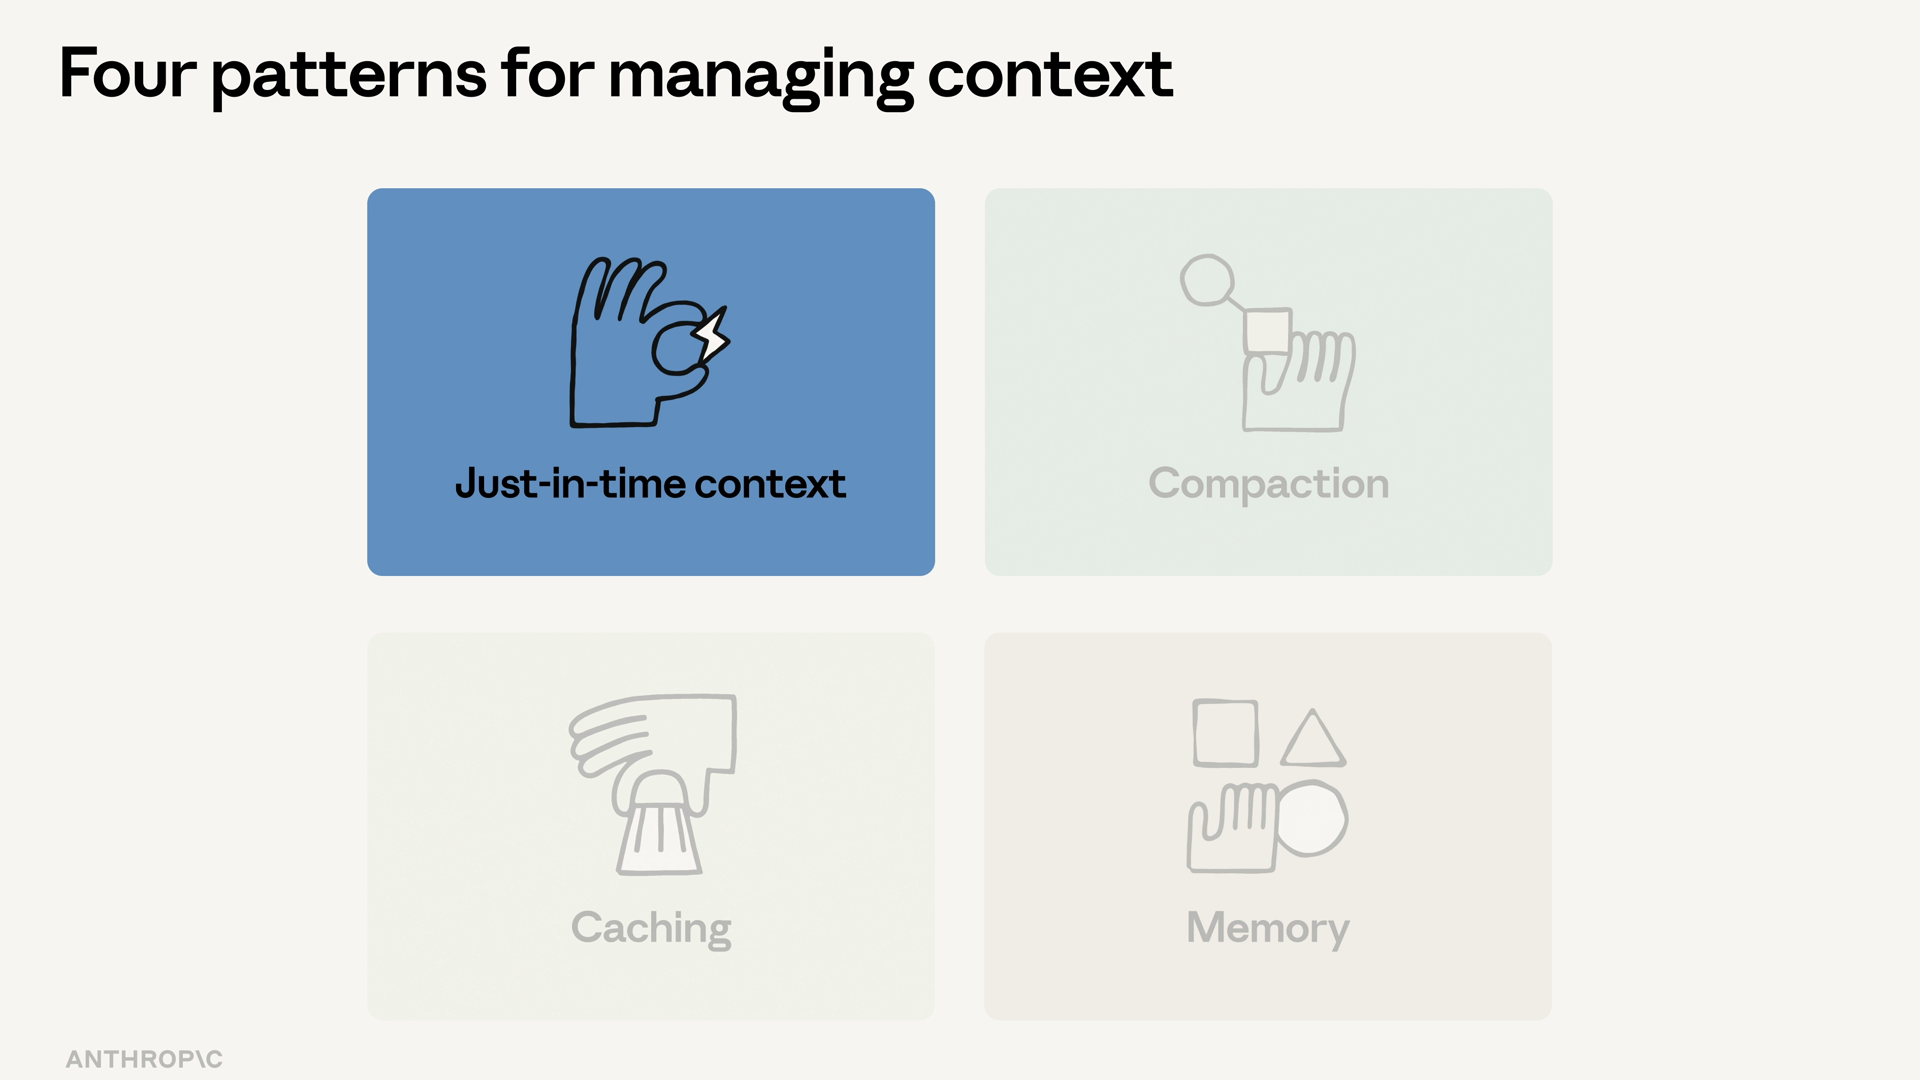
Anthropic发布了四种长期代理管理上下文的模式。其中三个是一流的API特性,一个是设计模式。
模式一:准时上下文
不要一开始就装满所有东西。现在加载代理需要的内容,等它需要时再用工具拉更多。
可以想象一下合规审查代理人。它不会把整本建筑规范书塞进系统提示里——它需要特定部分时会调用工具。这就是这四种设计模式:API 没有特别的,只是对加载内容和时间的刻意选择。lookup_building_code
模式2:服务器端压缩
当对话进行较长时间时,Anthropic 的服务器端压缩会将旧转化总结为单一块。你通过在请求中添加一个键,按住编辑,输入以下类型来选择加入:context_management
response = client.messages.create(
model=“claude-sonnet-4-5”,
max_tokens=1024,
context_management={
“edits”: [
{“type”: “compact”}
]
},
messages=messages,
)
API在输入超过触发阈值时自动汇总。你不必自己记录对话时长。
模式三:提示缓存
提示缓存让你标记请求的稳定部分——系统提示、工具定义、长文档——并以极低成本在调用中重复使用。
数学比看起来更重要。如果你的系统提示是4000个代币,并且每小时拨打100次,缓存就是一张可用账单和金融电话之间的区别。
模式4:记忆工具
需要在会话中保留一些背景:用户偏好、代理的运行笔记、上周的决定。推荐的原语是记忆工具。
具体流程如下:
Claude 通过工具调用读取和写入内存目录。
你在客户端实现存储后端——文件系统、数据库、加密存储,随你喜欢。
Anthropic 自动注入一条系统指令,告诉 Claude 在开始工作前检查内存目录。
分层排列图案
在生产应用中,你通常会同时叠加这四个。合规审查代理缓存其系统提示和工具定义,并通过 及时拉取建筑规范部分。lookup_building_code
每种模式处理不同的失败模式:成本、窗口大小、无状态性。选择那些符合你需求需求的。
回顾
上下文是克劳德在转弯时所见的一切——而且它既非自由也非无限。一旦窗口填满,请求就会失败。
即时操作:现在装上需要的,剩下的让工具拉进来。这就是这四个人的设计模式。
服务器端压缩:添加一个键,API 在输入超过触发阈值时自动汇总旧回合。context_management
提示缓存:标记请求的稳定部分,并以极低成本在多个调用中重复使用。
内存工具:Claude 通过工具调用读取和写入内存目录;你拥有存储后端,所以上下文会在会话间保持完整。
四个模式,一个目标。你可以手动布线,或者使用默认启用缓存和压缩的Claude托管代理。
什么是托管代理?
Claude 托管代理是一套用于大规模构建和部署代理的 API。你定义了具有特定工具、角色和能力的代理。你需要配置沙盒环境,配备合适的软件包和网络控制。然后你从自己的应用程序中触发会话,Claude 在一个隔离的容器中完成工作,具备完整的文件系统访问、bash 执行和网页搜索。
代理循环,为你托管
在底层,这是一个代理循环:Claude 推理、调用工具、读取结果,然后重复直到工作完成。如果你以前做过代理,可能你自己也写过这种循环。托管代理也把同样的循环托管在Anthropic的基础设施上,所以你不必运行它。
你会在Claude控制台的独立板块中找到“托管代理”。
理解这能解锁什么的最好方法是通过几个例子来学习。
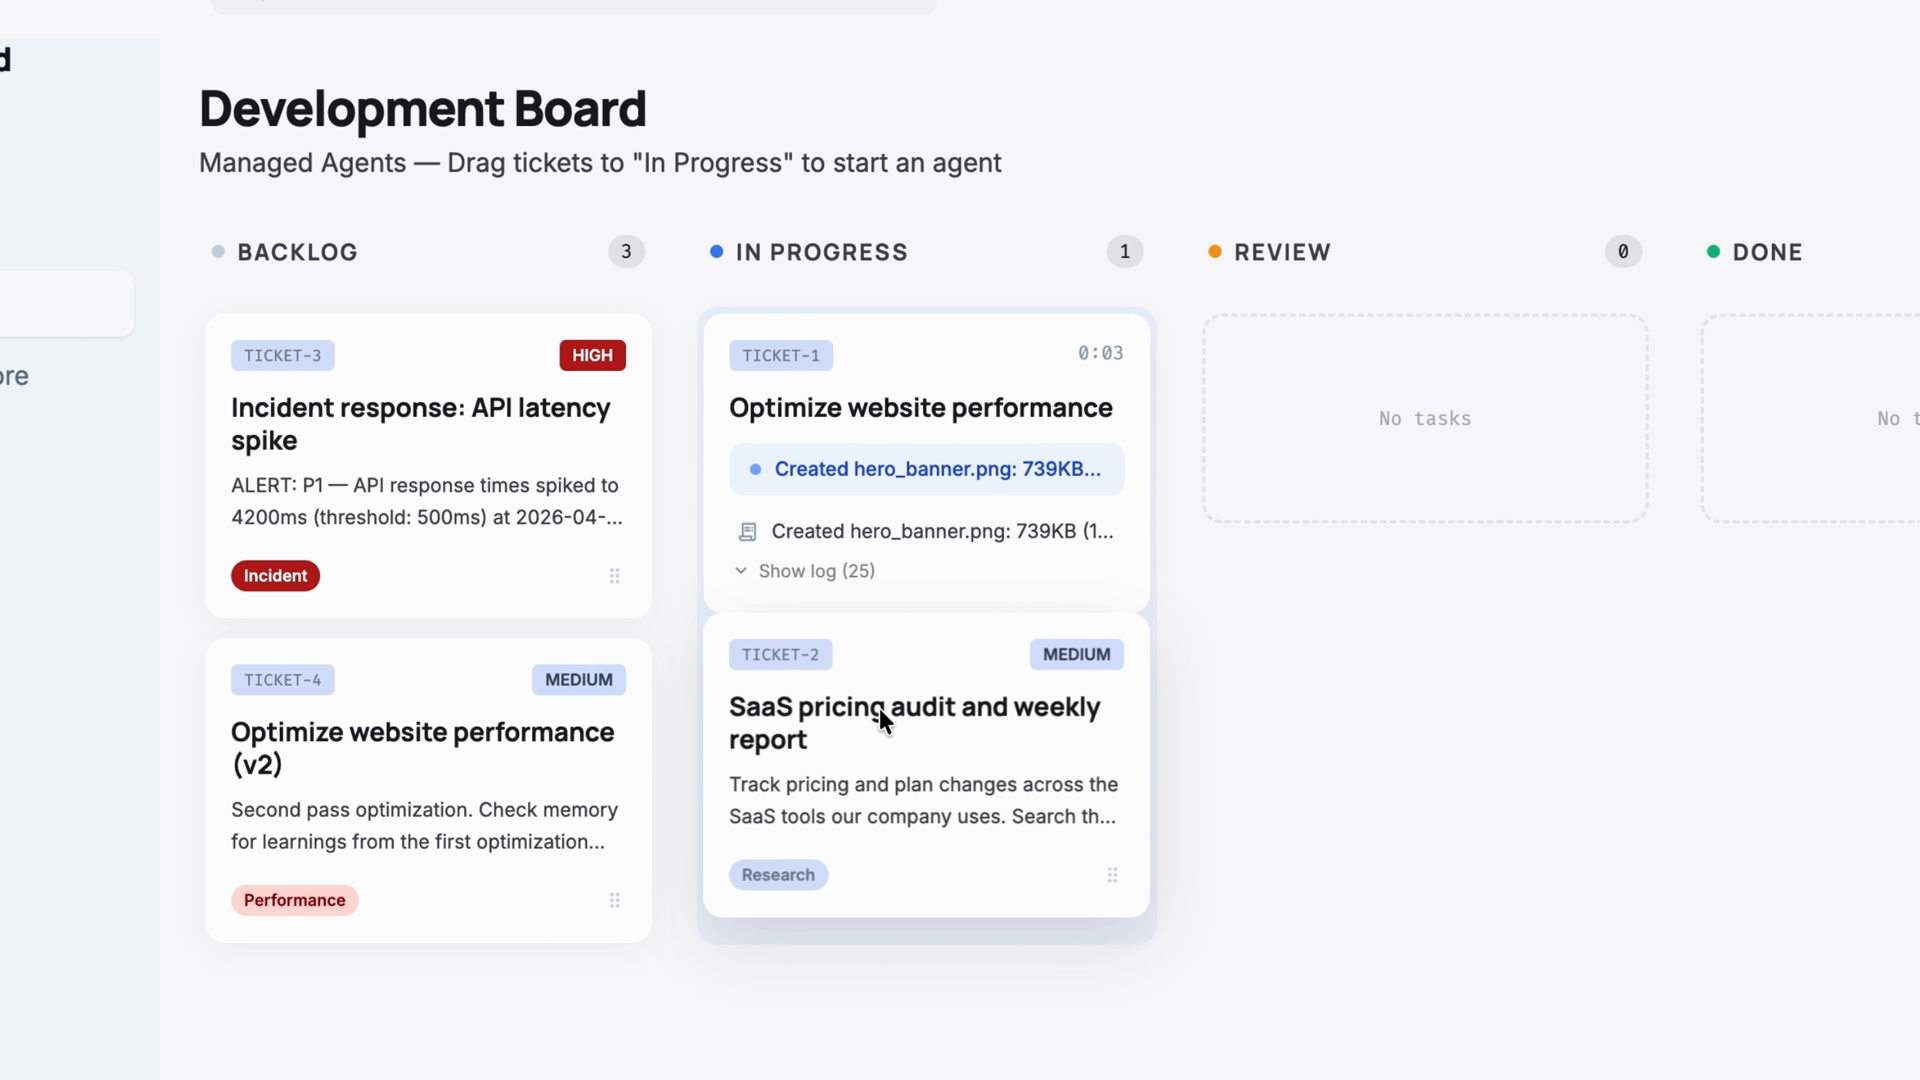
示例1:一个完成工作的看板
想象一下,看板板放在托管代理之上。你把工单拖到“进行中”栏,它会自动触发会话。假设工单写着“优化网站性能”。事情是这样的:
你的后端会创建会话。
会话指向你配置的环境,预装了Lighthouse和Puppeteer。
你的GitHub仓库会挂载到容器里。
现在Claude有了代码库、工具和一个定义完成内容的评分标准:
灯塔得分超过90
没有渲染阻断资源
所有图片 懒散加载
Claude 运行审计,然后开始压缩图片、内联 CSS 和延迟脚本。每次工具调用都会通过事件流实时回传到板块,所以你可以实时观看工作过程。
然后评分标准就启动了。一个独立的评分器在独立的上下文窗口中运行,根据你的标准评估输出。Claude 会阅读这些反馈,回去修正遗漏,然后重新提交。在演示中,这个循环让Lighthouse的评分提升到了96。
还有一点:你可以在第一张工单还在运行时拖过第二张。两个会话,两个容器,两个独立任务并行运行。
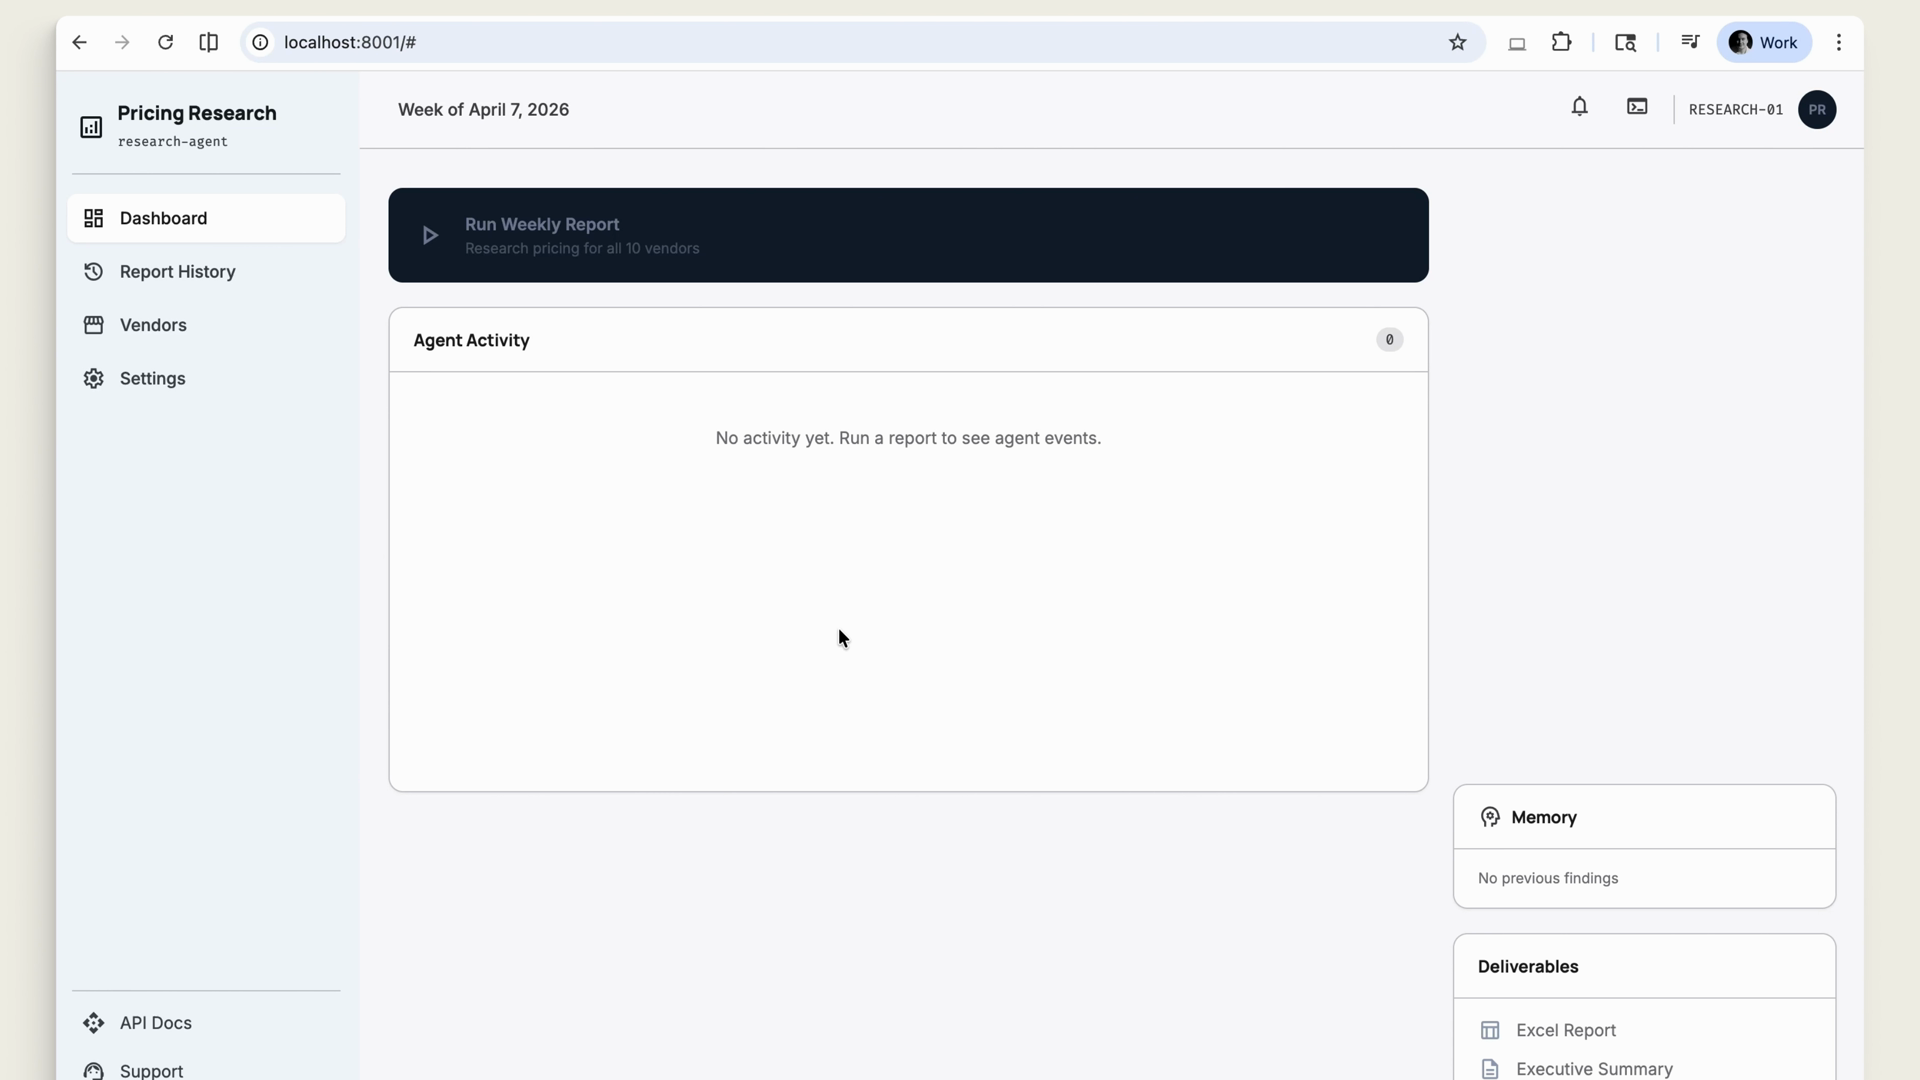
例子2:一个有记忆的反复出现的研究代理人
这里有另一种形式的代理:他们的工作是跟踪价格并规划公司所有SaaS工具的变动,并在站立前准备好报告。
每次运行时,特工:
在网上搜索当前价格页面,检查套餐等级变更,并标记可能影响您合同的新功能
在沙箱中用 Python 运行成本分析
使用Excel电子表格技能并撰写执行摘要
通过MCP服务器发布Slack链接并在Asana中创建审核任务
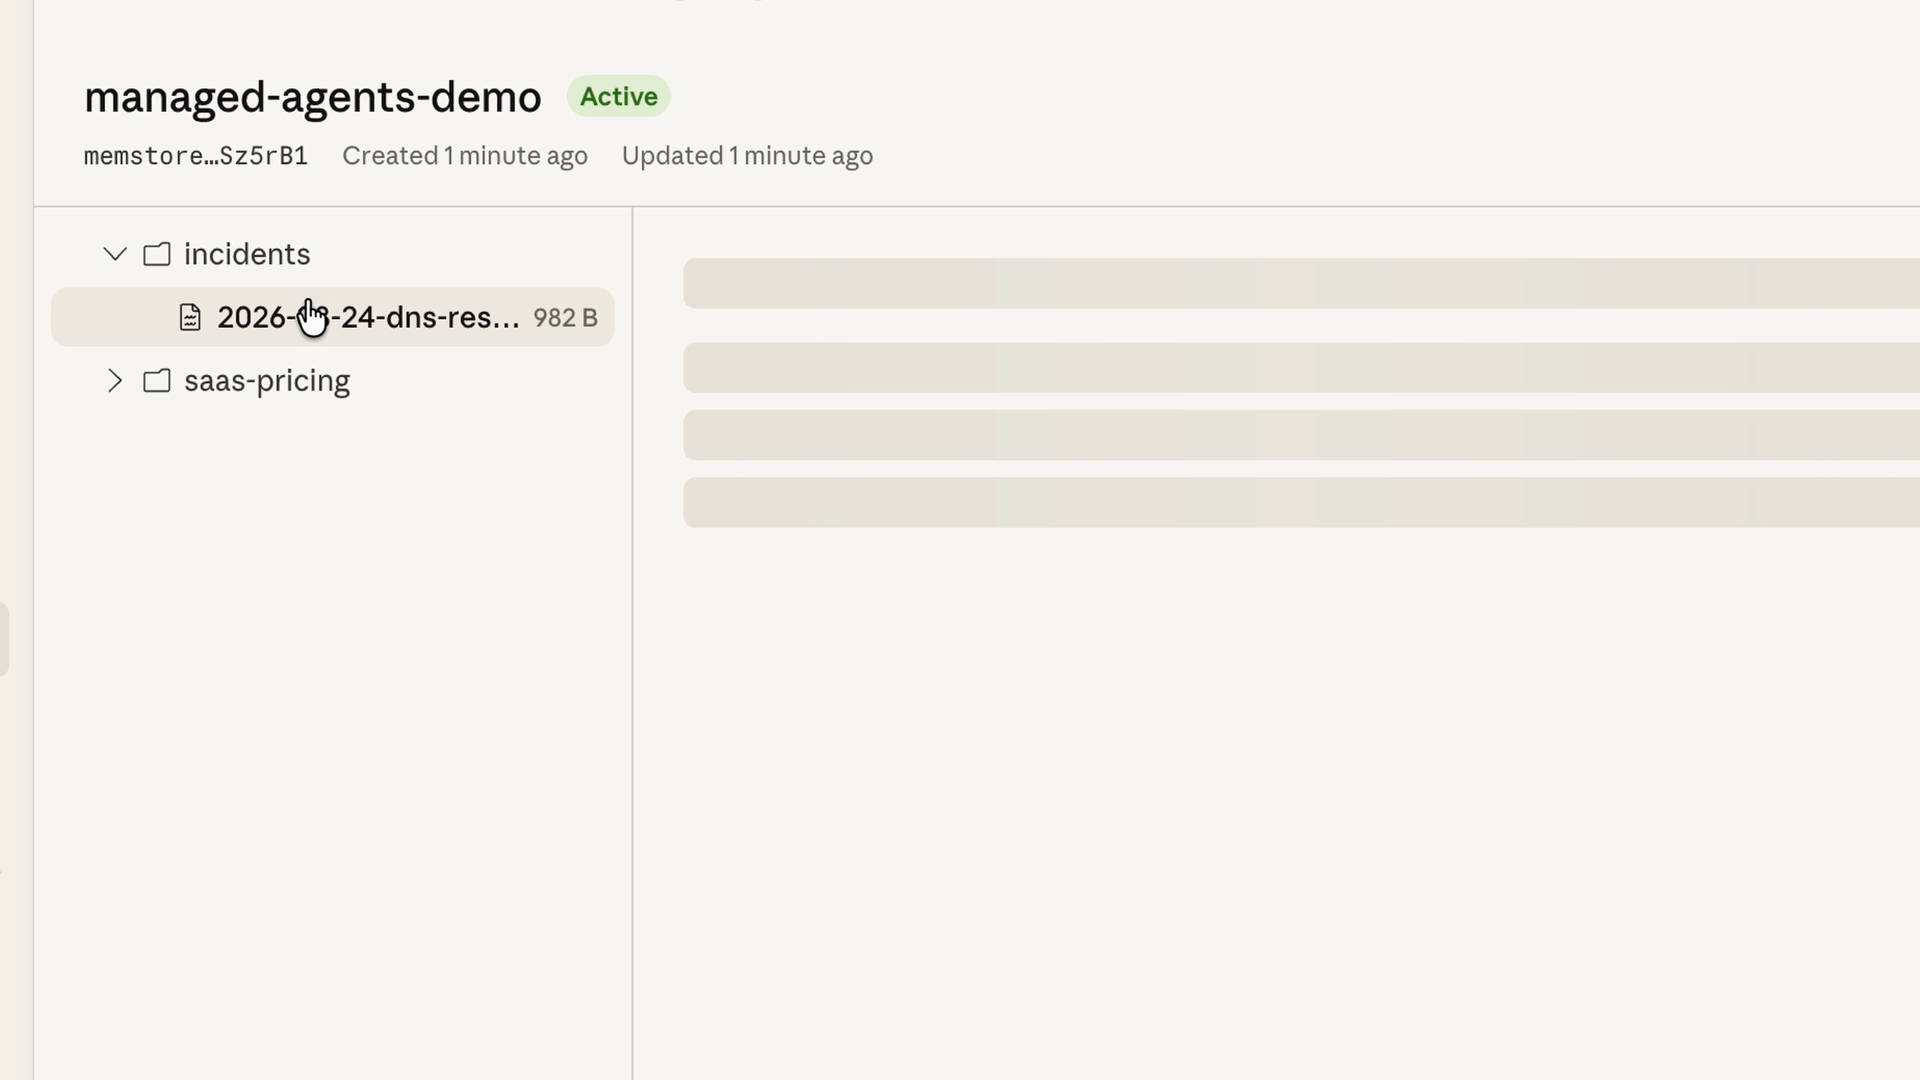
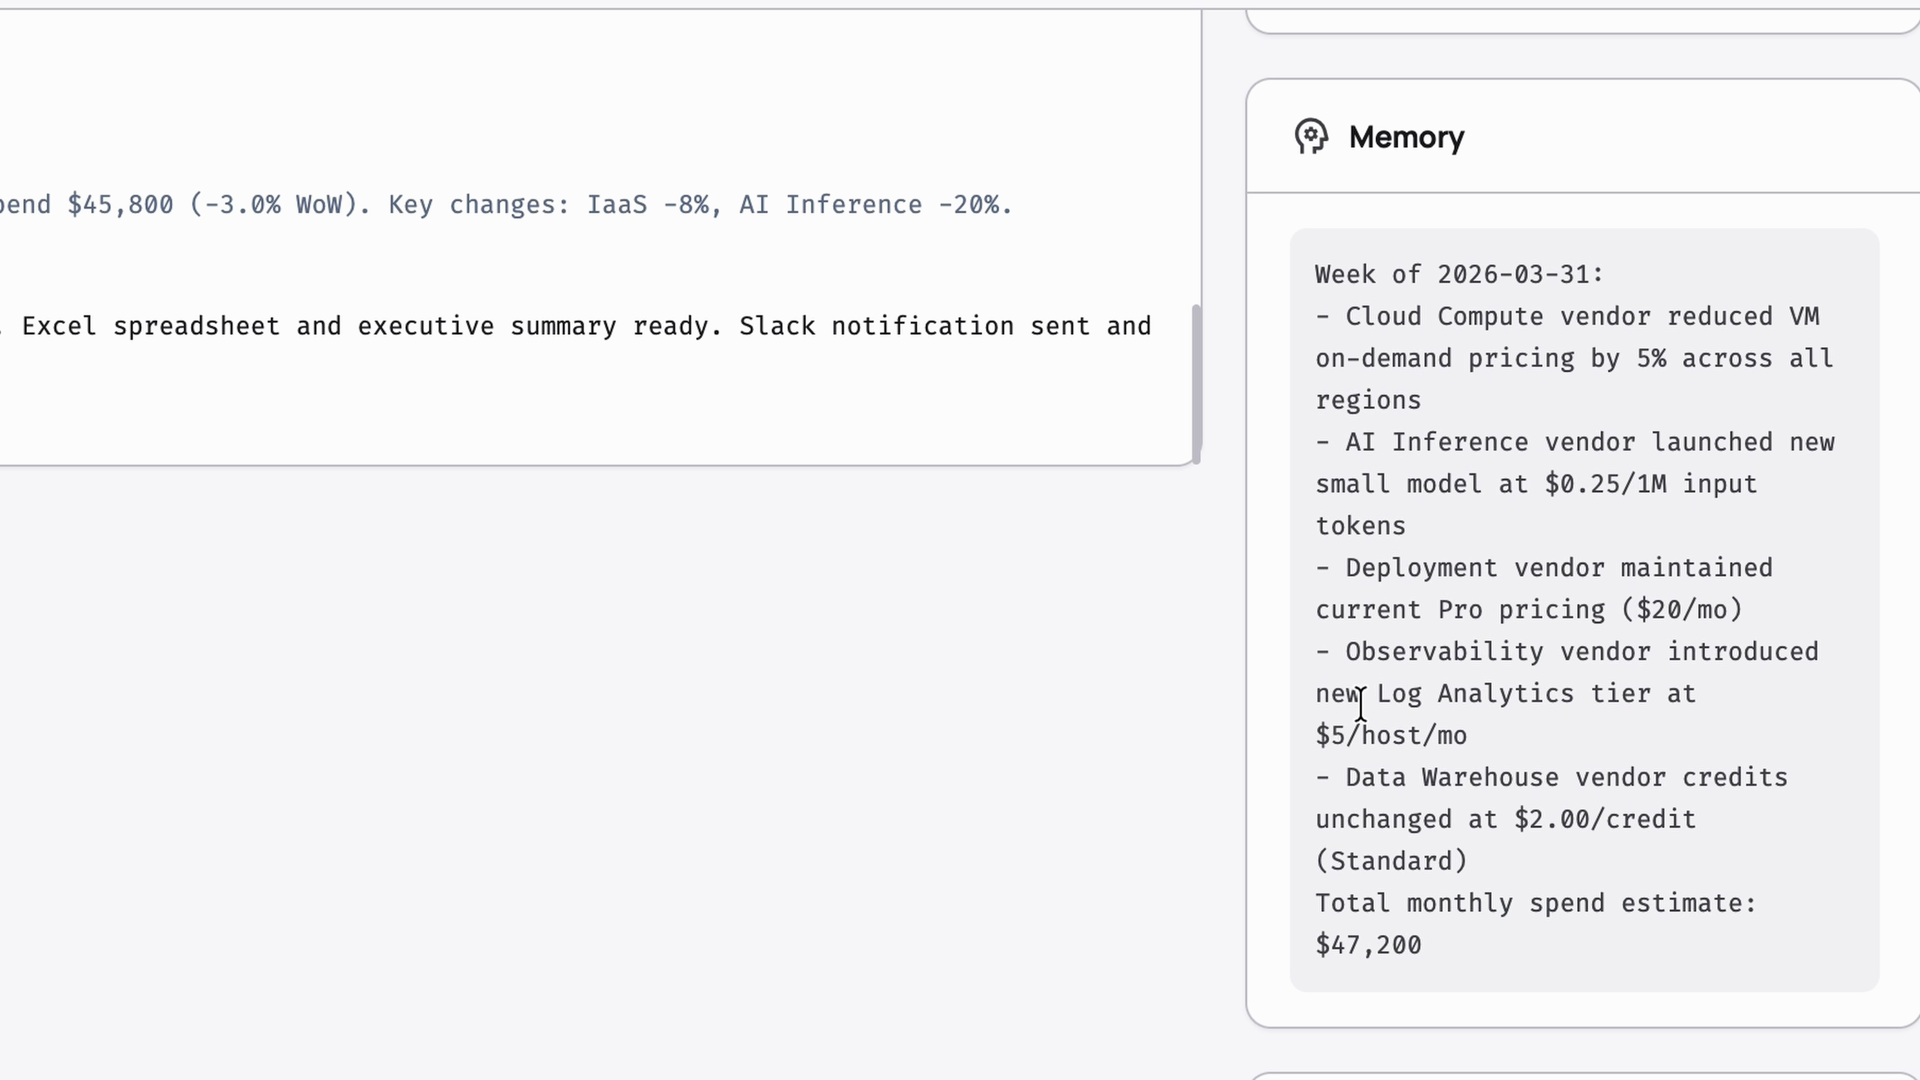
代理还会读取和写入内存存储。在开始之前,它检查了上周发现的情况。完成后,它会存储更改的内容。所以下周一的报告可以说“计算成本比上周低了15%”,而不是每次都列出相同的静态定价数据。
示例3:多名座席的事件响应
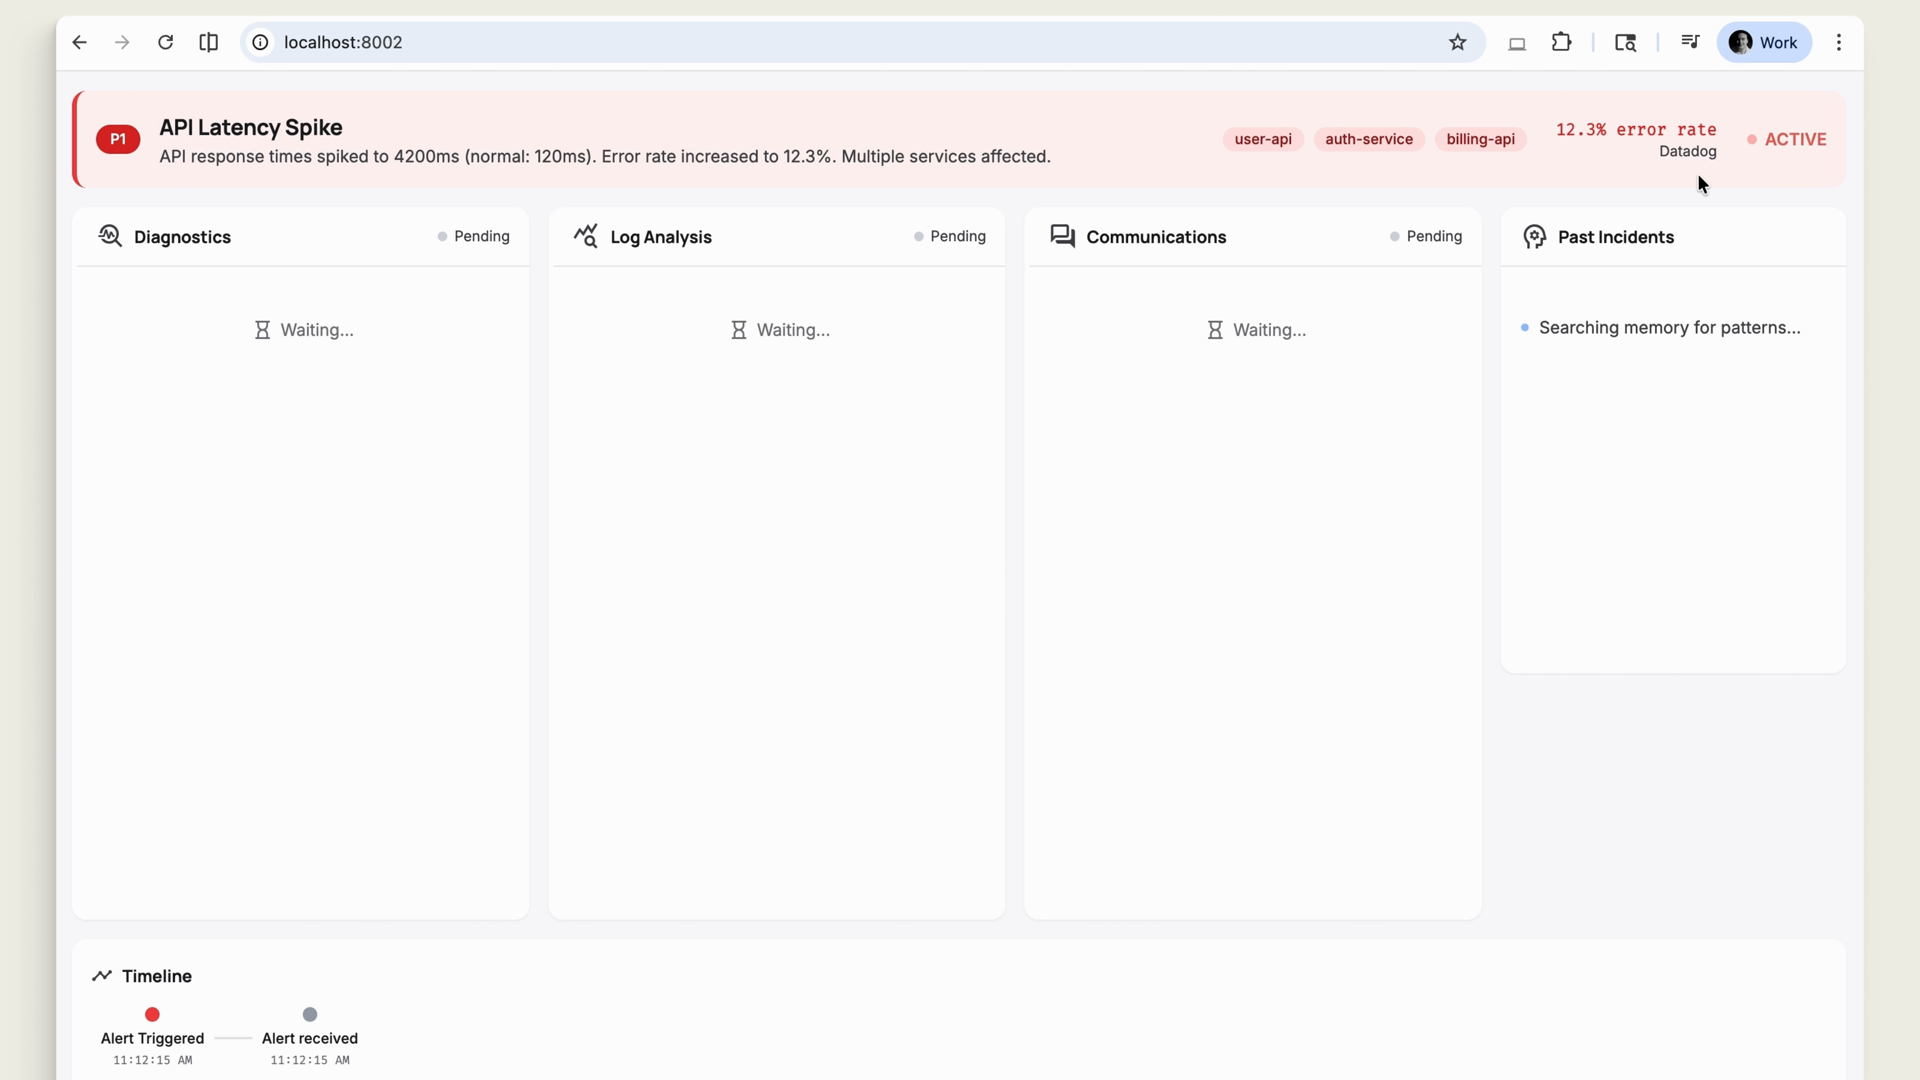
现在想象一下,你的监控堆栈发出警报。后端的自定义工具会接收警报负载,并将其作为工具结果发送到新的会话中。本次会话采用多代理协调:
协调员接收警报后,将任务委派给三位专家。
每个专家在同一共享文件系统上运行自己的上下文窗口。
专家们会反馈,协调员将他们的发现整合成一份单一事件摘要。
在摘要发送到Slack之前,权限策略会触发。你在屏幕上看到草稿,批准它,消息就会发出。敏感的行为等待人类。
记忆将这一切串联起来。协调者检查了内存存储中过去的事件,并标记出一个模式:“这看起来像两周前由错误配置TTL引发的DNS解析问题。”下一次类似警报响起时,客服人员会从该上下文开始,而不是从头诊断。
构建模块
在这些例子中,托管代理为开发者提供了工具,能够提供基于以下基础的完全托管、有状态代理体验:
代理——具有特定工具、角色和能力的定义
会话——你从自己的应用程序中触发的单个运行
环境——配备合适的包和网络控制的沙盒
工具——包括后台的定制工具
MCP — 连接Slack和Asana等服务
内存——代理在启动前读取并写入的存储
结果——定义和检查完成内容的评分标准和评分标准
多代理协调——协调员委派给专家
回顾
Claude 托管代理是一套用于大规模构建和部署代理的 API,托管于 Anthropic 的基础设施上。
它运行着熟悉的代理循环——推理、调用工具、读取结果、重复——在一个隔离的容器中,支持文件系统访问、bash执行和网页搜索。
会话运行在你配置的环境中,并行运行,并实时回传工具调用给你的应用。
评分标准和分级表可以让你定义成功标准;克劳德不断迭代,直到遇到它们。
内存、MCP服务器、定制工具、权限策略和多代理协调完善了有状态代理体验。
你定义什么叫做。Claude 工作到达到那个阶段。
构建你的第一个托管代理
如果你手搭建过代理循环,你就知道流程:while循环、停止理由开关、工具执行。这样可以,而且很多功能形状其实是正确的。但有时这个循环会运行很长时间——几分钟,甚至几个小时——跨越许多工具,需要保留状态、写入文件,并在网络出现故障后继续工作。那时你就不想在服务器上运行循环了。你想委派它。这就是管理代理的本质。
什么是托管代理?
托管代理是一种在Anthropic基础设施上运行的代理循环,而不是在你的基础设施上运行。你描述一次代理,给它一个工作环境,然后开始会话。Anthropic运行循环,你只需在运行时将事件流回。
每个 API 账户默认启用托管代理——无需特殊访问权限。
四大原始元
共有四个原语,顺序如下:
代理——角色:模型、系统提示符和工具集。这种方式可以在多次运行中重复使用。
环境——代理运行的环境:云端或本地端,网络配置等。
会话——代理在特定环境中的单次运行。会议是工作单元。
事件——进出的信息:代理的操作、工具调用、结果、回复。
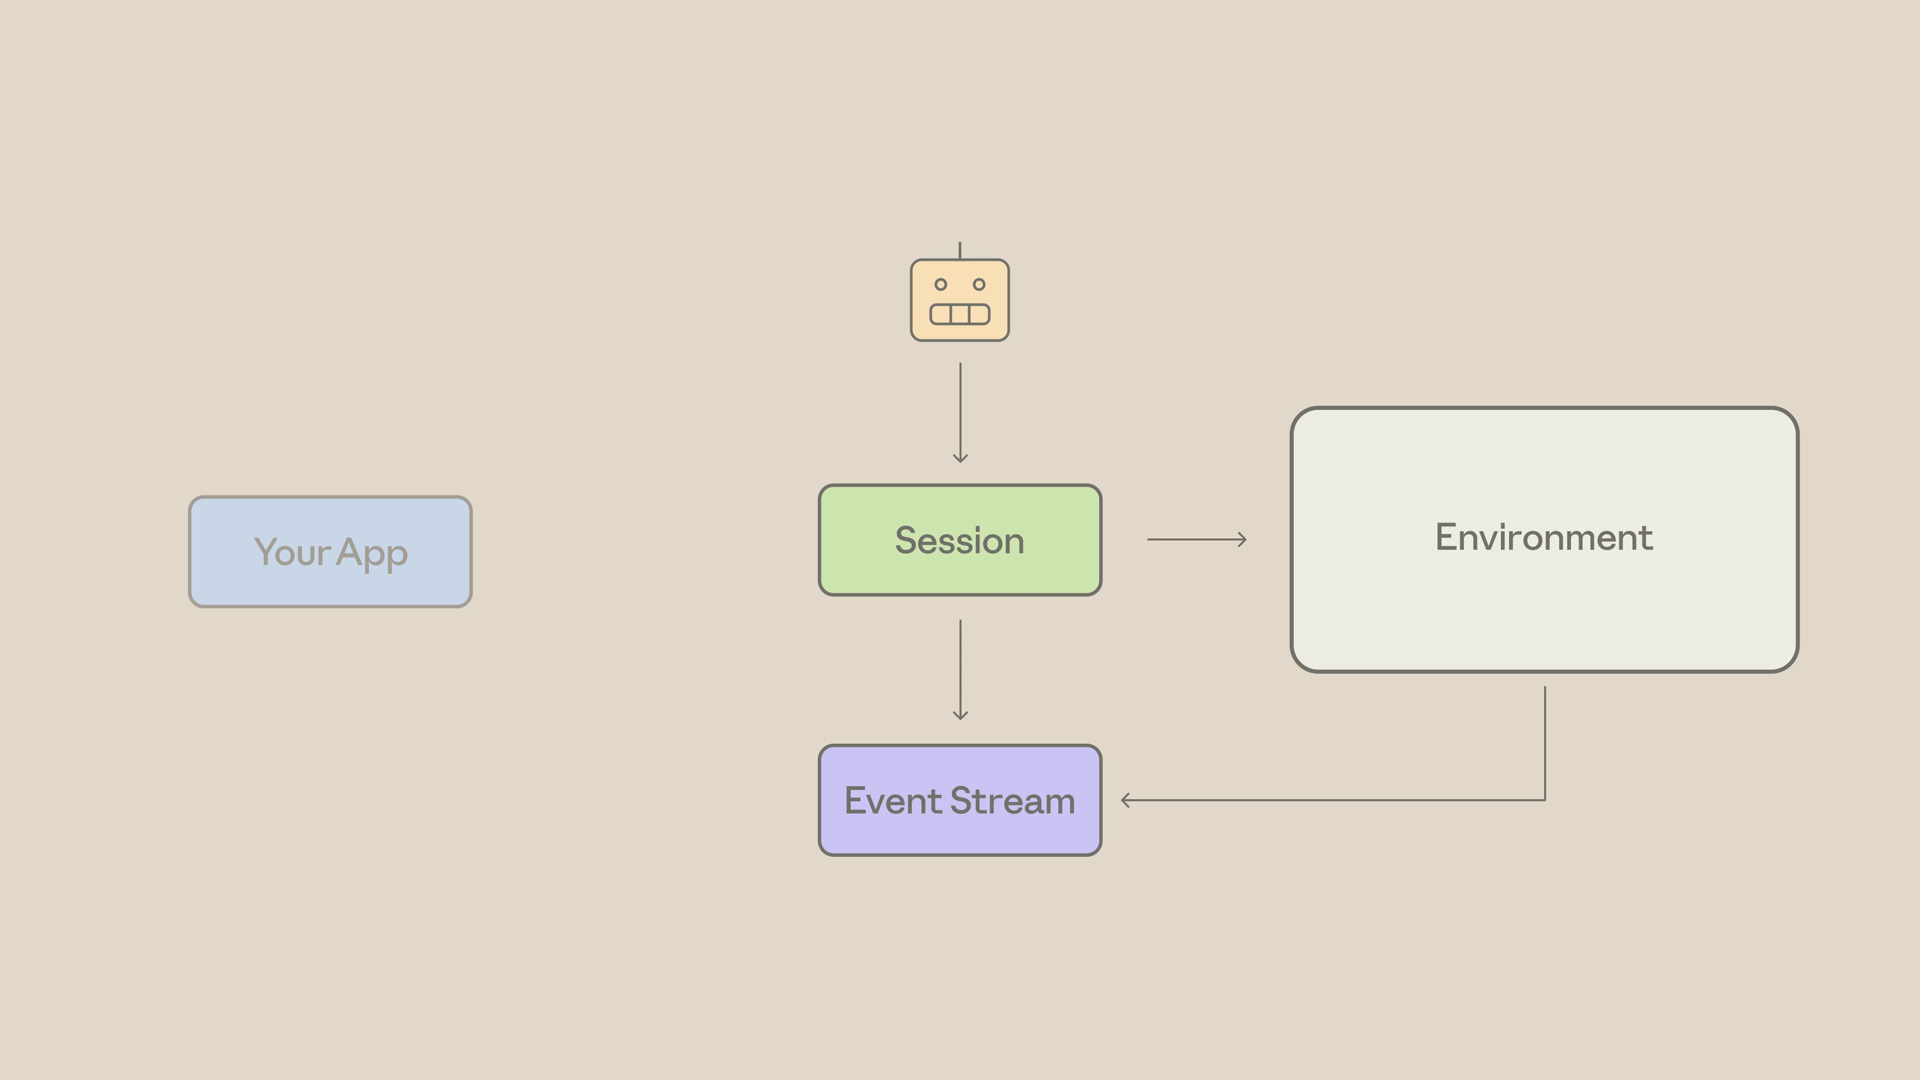
以下是这些环节的组合方式:你的应用与会话对话,会话驱动环境内的工作,所有发生的事情都会通过事件流流回去:
注意这里的变化:你不再运行一个长时间循环。你发送活动和阅读活动。
最小的托管代理
让我们构建一个最小的托管代理,能做一些有用的事:在临时驱动器中创建一个文件,计数其行数,然后反馈。
工具方面,我们将使用代理工具集——Anthropic捆绑的文件、bash和网页工具。它们对这项任务来说很合适,所以我们不需要自己定义任何工具。
步骤1:创建代理
首先,我们创造代理。请注意数组中定义的代理工具集——这就是捆绑的工具集:tools
import anthropic
client = anthropic.Anthropic()
agent = client.beta.agents.create(
name=“Line Counter”,
model=“claude-opus-4-8”,
system=“You are a helpful agent that completes small file tasks.”,
tools=[
{“type”: “agent_toolset_20260401”, “default_config”: {“enabled”: True}}
],
)
记住:该代理是可重复使用的。创建一次,然后在多个会话中运行。
第二步:创造环境
接下来是环境。这启动了容器模板——云端,支持不受限制的网络。这就是文件实际写入的沙盒:
environment = client.beta.environments.create(
name=“line-counter-env”,
config={
“type”: “cloud”,
“networking”: {“type”: “unrestricted”},
},
)
步骤3:创建会话
然后我们创建一个包含代理和环境的会话,并添加一个可选标题。会议是工作单位:
session = client.beta.sessions.create(
agent=agent.id,
environment_id=environment.id,
title=“Count lines demo”,
)
步骤4:打开直播,然后发送开球
现在我们打开事件流——注意到我们先做了这件事。直播只能传递开启后发生的事件,所以一定要在发送开球消息前打开直播。然后我们把用户消息发送到直播中:
with client.beta.sessions.events.stream(session_id=session.id) as stream:
Stream is open — now send the kickoff
client.beta.sessions.events.send(
session_id=session.id,
events=[
{
“type”: “user.message”,
“content”: [
{
“type”: “text”,
“text”: “Create a file in the temp directory, “
“count its lines, and report back.”,
}
],
}
],
)
注意它是复数。事件是这个API中一切流程的方式。events
步骤5:消费水流
最后,我们消费了这条流。本次演示有三种活动类型:
agent.message——克洛德的文本
agent.tool_use——克洛德选的工具
session.status_idle—— 代理完成
for event in stream:
if event.type == “agent.message”:
for block in event.content:
if block.type == “text”:
print(block.text, end=“”, flush=True)
elif event.type == “agent.tool_use”:
print(f“\n[tool] {event.name}“)
elif event.type == “session.status_idle”:
print(“\n— Agent done —”)
break
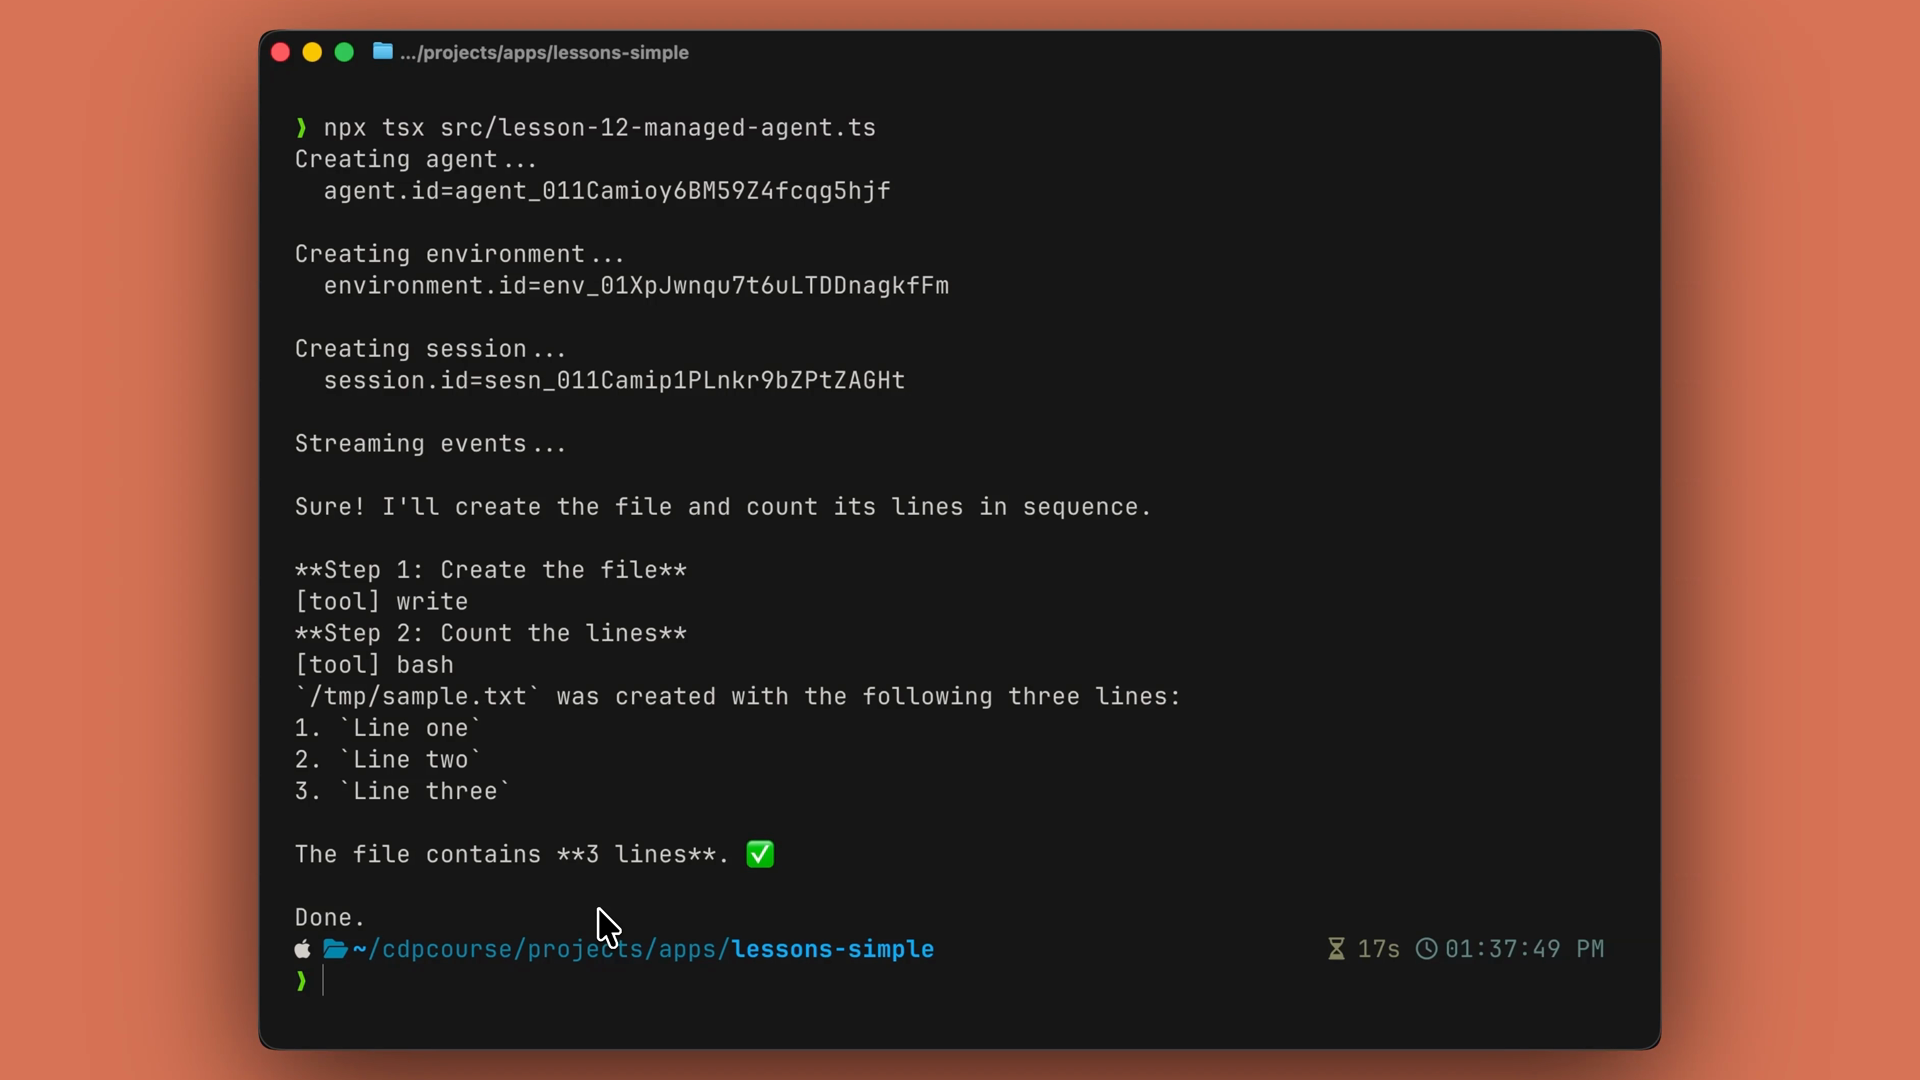
运行它,输出就是代理大声推理——实际文本、它选择的工具,以及最终的答案。这些都是在Anthropic的容器里运行的,不是你的:
贸易
通常,我们有自己的环路,必须控制一切。而托管代理则是委托这个循环、沙箱和可重复性——然后直接接收事件流。
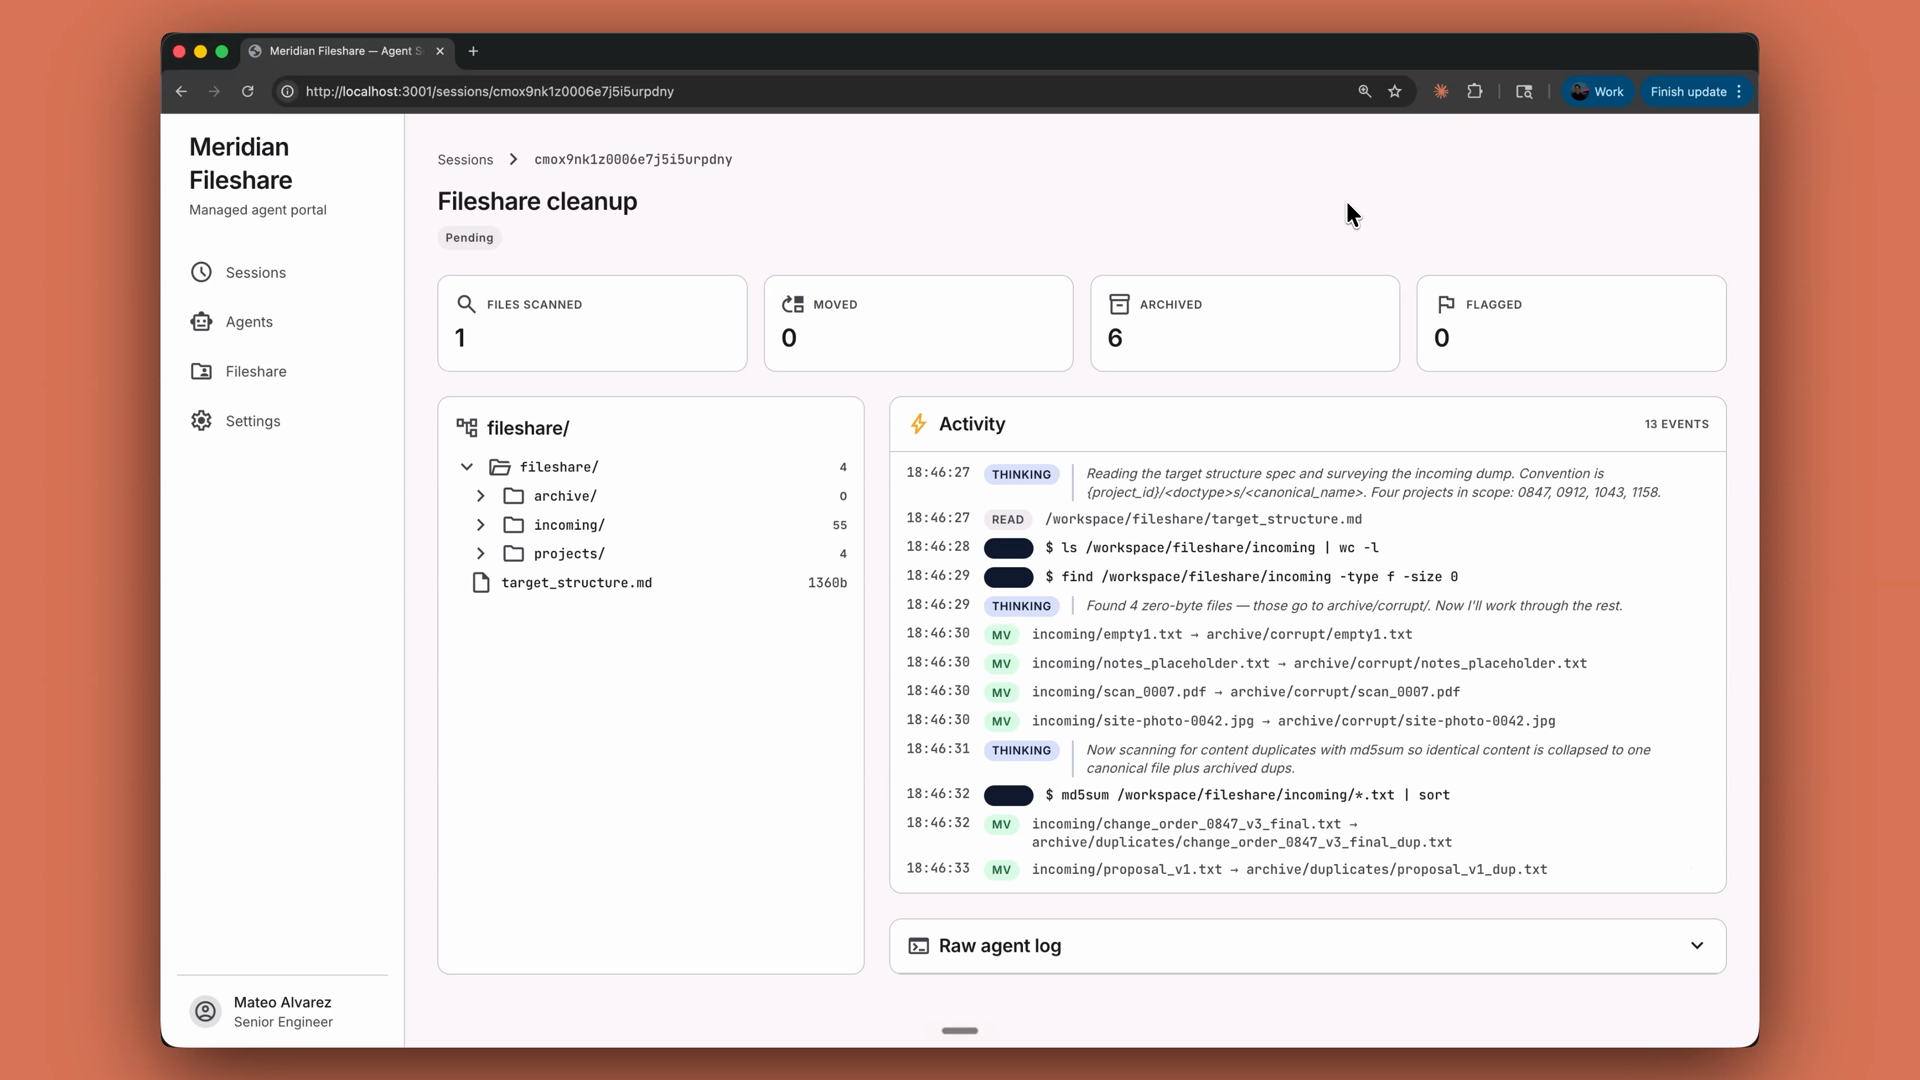
在生产应用中,这种形状适合长期运行、处理文件的“帮我整理”任务。想象一下文件共享清理:托管代理读取目标目录结构规范,走动混乱的进来文件夹,将文件移到正确的项目文件夹,归档重复文件和零字节垃圾,并标记任何无法确定放置的内容——所有这些过程在一个可以对数千个文件运行数分钟的会话中。这是真实应用中的表现——一个文件共享清理仪表盘,实时直播代理的活动,负责分类、归档和标记文件:
回顾
托管代理是代理循环,在Anthropic的基础设施上运行,而不是你的服务器。
流程是:创建代理,创建环境,创建会话,发送事件,然后流式事件输出。
代理(模型、系统提示符、工具集)可跨运行重复使用;该场次为单次运行;事件是一切流动的方式。
发送启动消息前先打开活动流——它只发送开启后发生的事件。
注意三个事件:(文本)、(工具选择)和(完成)。agent.messageagent.tool_usesession.status_idle
当循环运行过长、工作过多或需要经历小插曲时,可以选择托管代理。想要完全控制时,可以选择手动环。
使用Claude代码构建
手动编写调用 Claude API 的代码没问题,但还有一条更快的路径:让 Claude 帮你写。在本课中,我们将使用Claude代码从一个已存根的文件填充API集成——使用你在本课程中学到的原语。
从一个小册子开始
项目很简单:一个可以接收天气的TypeScript文件。其中包含两个小作品:
getWeather ——接受城市并返回温度和条件。
run —— 一个应该使用工具运行器和 Claude TypeScript SDK 的函数。
工具跑道是负责工具调用和代理环路的部件,所以你不用手动接线。
Claude API 技能
Claude 代码自带一个叫 Claude API 的内置技能。你可以直接用 调用它,或者 Claude Code 在检测到你使用 TypeScript SDK 时会自动调用它。/claude-api
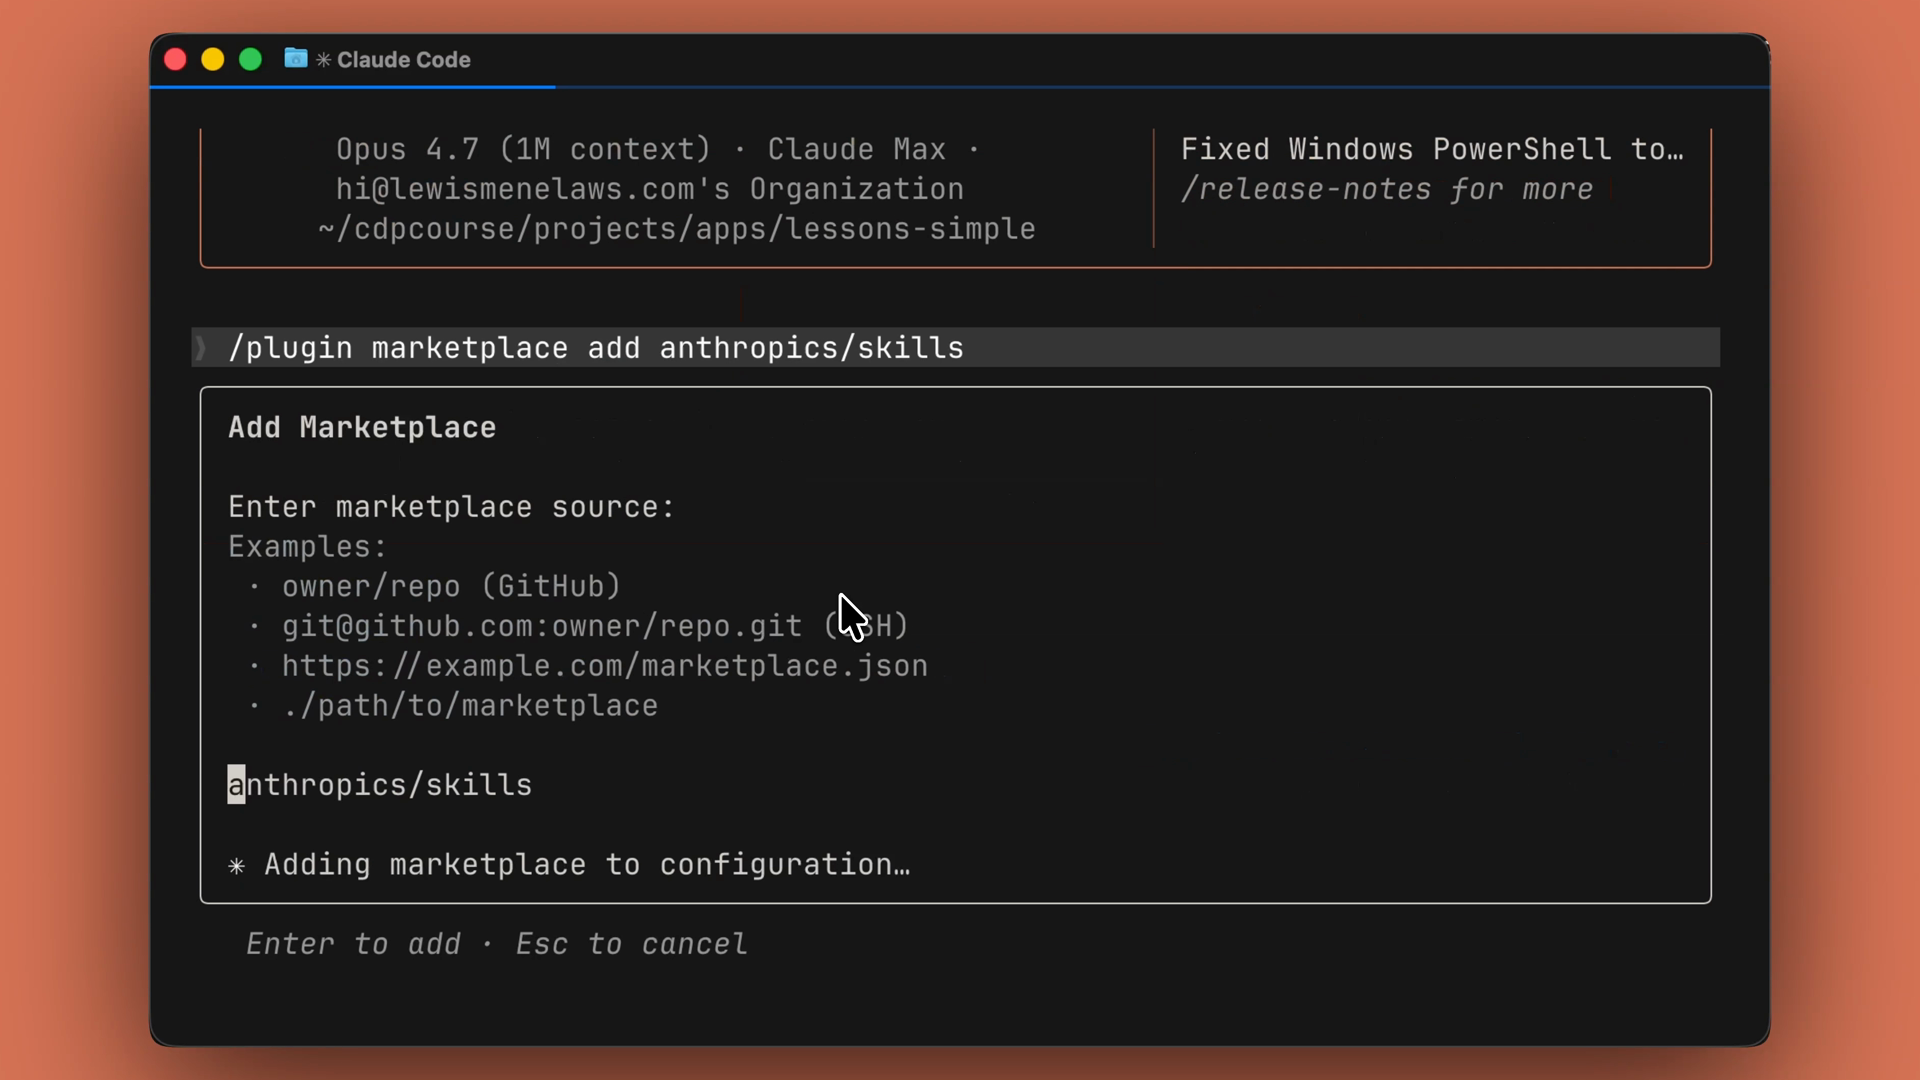
如果你没看到这个技能,可以从市场上添加:
/plugin marketplace add AnthropicsSkills
注意《人类学》结尾的s——很容易被忽略。
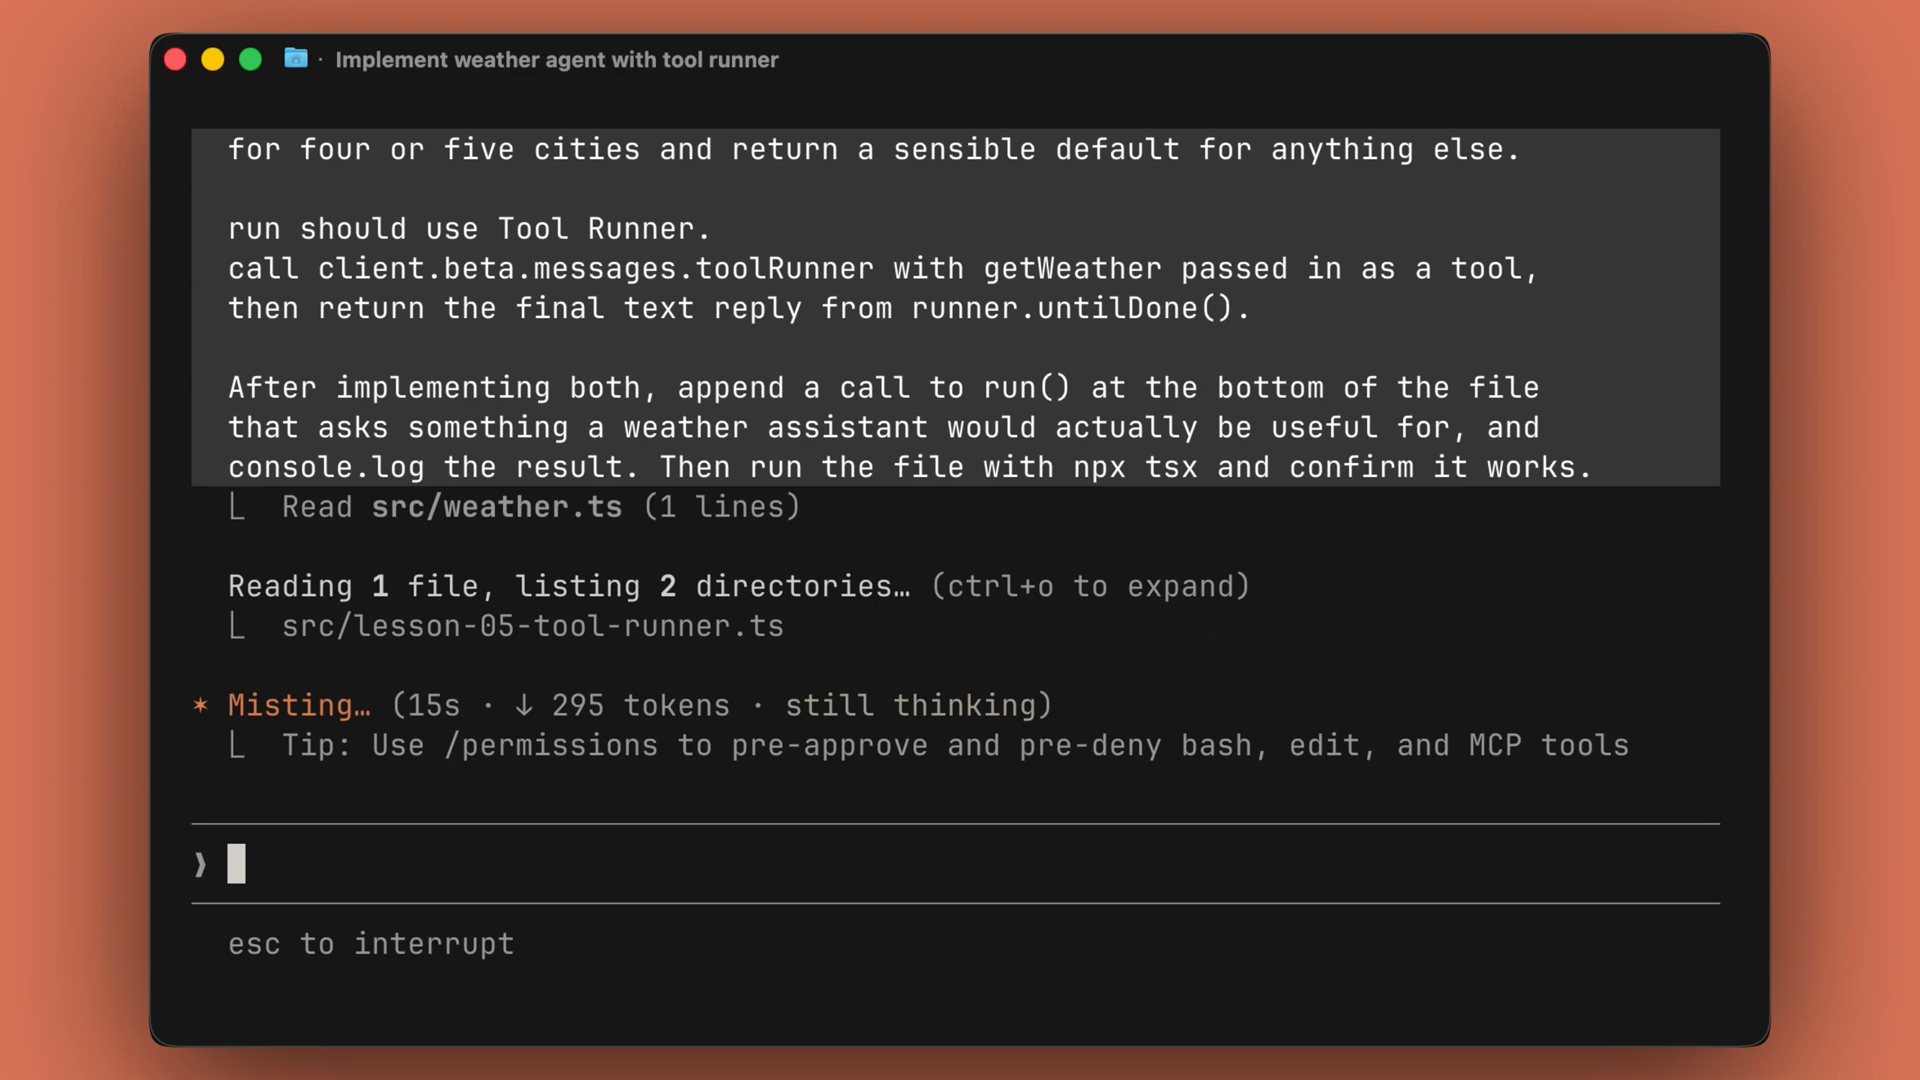
一个提示,代码正常工作
在终端打开项目文件夹,启动Claude Code。
接下来只需一个提示。一个好的提示词有三点作用:
It names the file you want changed.
It names the pattern you want used.
It names the end state you expect.
Claude Code 随后填充和对应类型,在文件底部附加调用,执行脚本并报告输出。如果出现错误,它会读取错误信息并修补代码。getWeatherrun
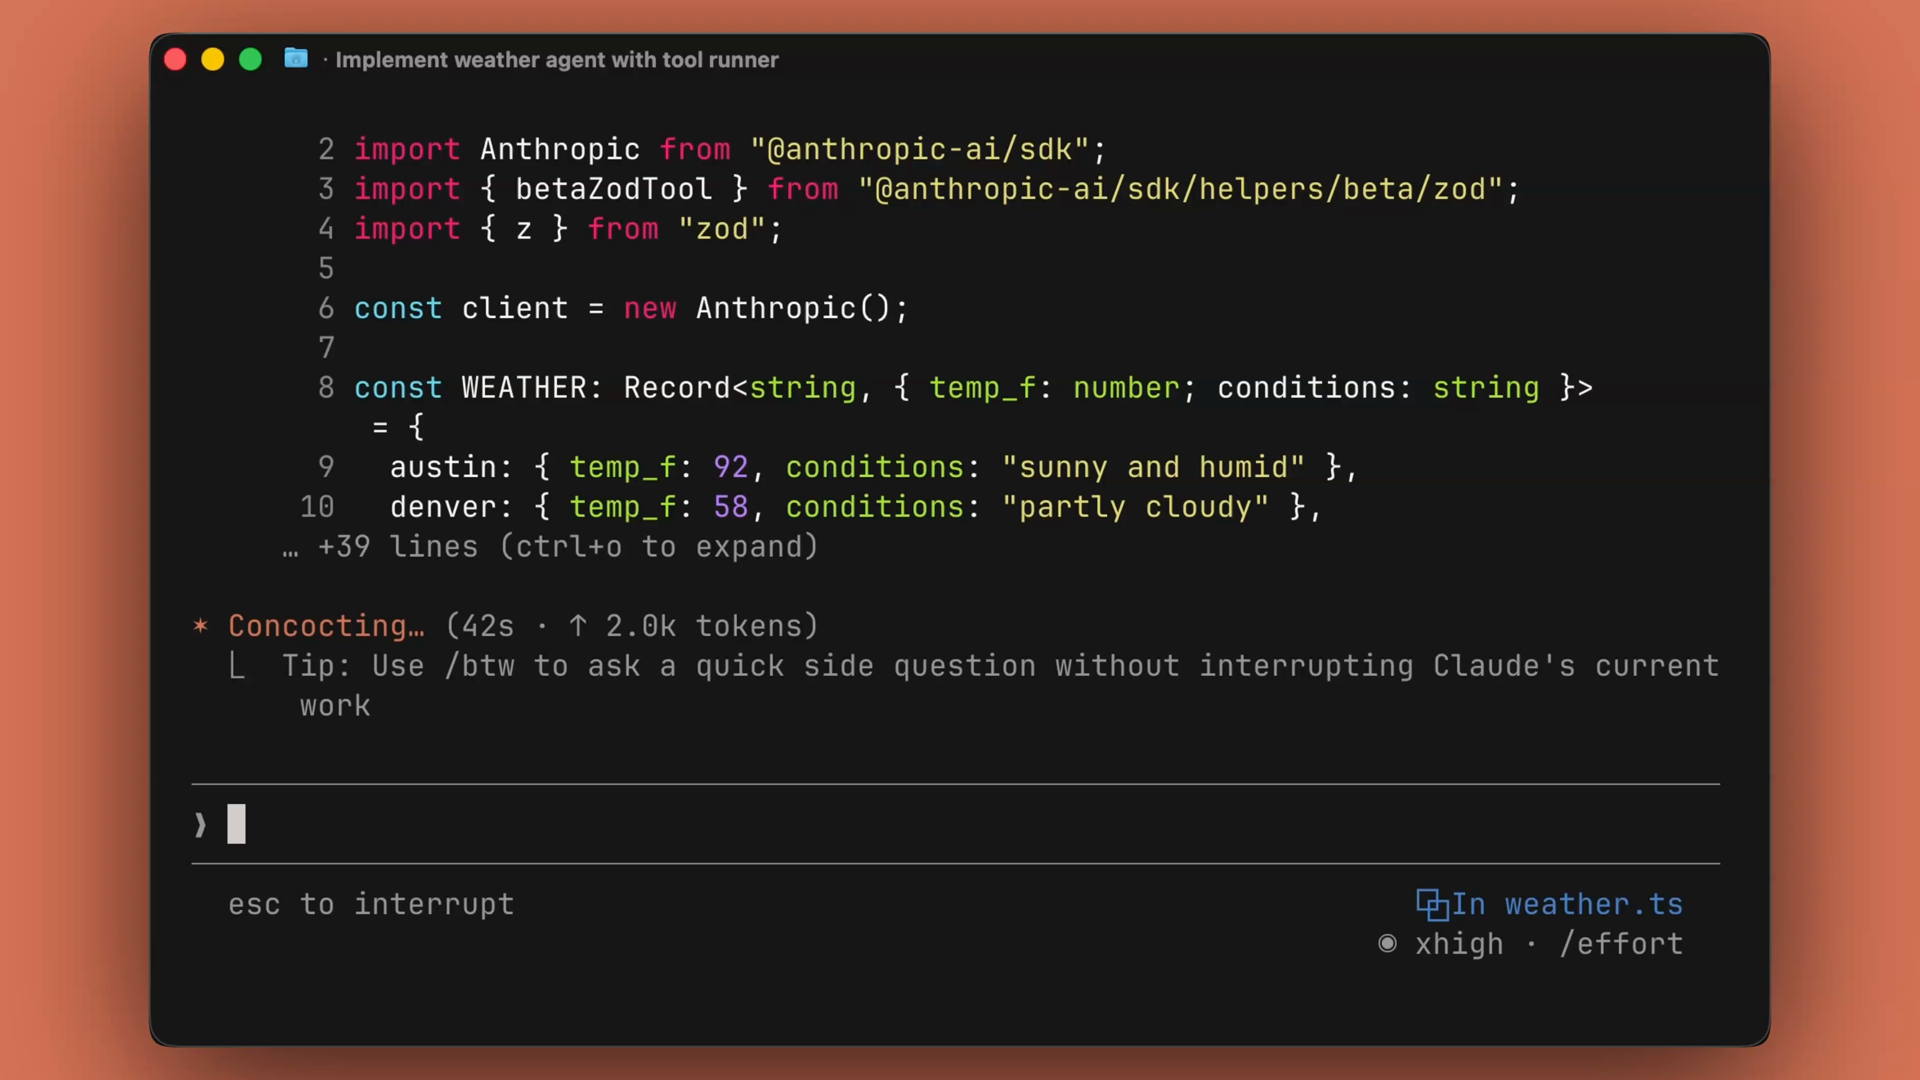
Claude Code 所产出的内容
在这次运行中,Claude Code 创建了一个 Zod 工具,解析输入并根据城市类型返回输出。它还创建了工具运行工具和我们要求的功能,并打印了代理循环的最终结果。run
需要记住的模式
你在 Claude API 上写的大多数内容都有一个熟悉的形状:
定义一个工具。
交给跑腿的人。
返回结果。
你不需要每次都凭记忆输入。相反,先把文件存根,交给Claude Code,然后直接查看差异。
回顾
Claude Code 是一个代理,可以在你的终端内编辑文件并执行命令。
内置的 Claude API 技能在 Claude Code 检测到 TypeScript SDK 时会自动加载,或者你也可以用 ./claude-api
给它一个提示,给文件命名、模式和结束状态——它编写代码、运行代码并修正错误。
Claude API 代码遵循熟悉的结构:定义一个工具,交给运行者,返回结果。把它挂掉,委托处理,审查差异。