FDE行为能力测评与强化训练体系
以可观察行为和可验证产物为证据,建立从能力测评、训练强化到真实交付的完整方法。
执行摘要
这套体系的目标不是判断你“懂不懂 AI”,也不是判断你“会不会使用 ChatGPT、Codex、Claude Code”,而是回答一个更严格的问题:
面对陌生、模糊、信息不足、模型能力持续变化的真实业务问题,你是否能够稳定地完成:发现问题 → 收敛问题 → 判断 AI 机会 → 设计人机工作流 → 快速实现 → 定义 Eval → 调试 Bad Case → 上线验证 → 沉淀复用。
这与当前 OpenAI 对 Forward Deployed Engineer 的实际定义高度一致。OpenAI 当前 FDE 岗位要求从 discovery、technical scoping、system design、build 一直到 production rollout 全链路负责,并用生产采用、可量化的工作流影响和 eval-driven feedback 衡量成功;岗位同时明确要求在必要时直接写代码,并把有效模式沉淀为工具、playbook 或可复用 building blocks。医疗 FDE 岗位进一步把架构、实现、评测、生产化、handoff、human-review、observability、acceptance criteria 都纳入职责。[1]
因此,你老师提出的四项能力:
技术判断 / 机会判断 / 方案判断 / 评测判断
应该被视为核心决策层;但要达到真正的 AI Native + FDE,还必须叠加:
问题收敛、AI 工作流设计、即时学习与“会忘”、知行合一、Bad Case 调试、工程闭环、部署采用、复用沉淀。
当前 agent-first 工程实践也正在强化这一变化。OpenAI 在 2026 年的 Harness Engineering 实践中,把人的工作概括为从“亲自写代码”转向设计环境、明确意图、提供工具与反馈循环;当 agent 失败时,重点不是“再试一次”,而是定位缺失的能力、上下文、工具、架构或验证机制。[2] Anthropic 对约 40 万个 Claude Code 交互会话的研究同样观察到,人通常掌握更多“做什么”的规划决策,而 agent 承担更多“怎么做”的执行决策;领域专家的优势主要表现在问题定义、验证要求和错误恢复,而不是单纯敲代码。[3]
所以本体系采用一个原则:
不靠自述证明能力,只靠可观察行为和可验证产物证明能力。
“我平时很 AI Native”“我很会 Agent”“我很擅长产品”全部不计分。只有在限时任务中表现出的行为、决策、代码、trace、eval、实验结果和复盘才计分。
评测也不能是“感觉不错”。OpenAI 当前评测指南明确反对 vibe-based eval,建议采用任务特定的评测、尽早评测、记录日志、自动化评分并使用人类反馈校准自动评分,同时覆盖典型、边界和对抗案例。Agent 工作流则应先通过 trace 定位模型调用、工具调用、handoff 和 guardrail 等工作流级失败,再逐渐沉淀为可重复的数据集和 eval run。[4]
**默认约束。**你没有指定参与人数、预算、平台、模型供应商、技术栈、云平台、数据敏感等级和学习时间,因此本设计均视为“无特定约束”。为了达到你要求的“快速提升”,课程默认采用 10 周、每周约 8–12 小时、个人训练、可使用 AI 工具、至少完成一个真实可运行项目 的强度;具体产品和模型不作为能力本身评分对象。
最终不是得到一张“AI Native 82 分”的漂亮成绩单,而是形成一套可以反复证明的证据链:
Assessment → Case → Decision Log → Prototype → Trace → Eval Set → Bad Case → Regression → Pilot → Adoption Metrics → Playbook。
能力模型与可观察行为
本报告把你提供的老师讲述作为领域先验,但把其中“看起来像能力”的抽象概念进一步拆成可以实际评分的行为。这样才能区分“知道方法论”和“真正能做到”。
| 能力维度 | 可测子技能 | 高水平可观察行为 | 低水平/危险行为 |
|---|---|---|---|
| 技术判断 | 模型能力边界、架构选择、工具/Agent/Harness 判断、成本延迟、安全、技术变化→业务影响 | 能解释“技术变化具体打开了什么过去做不到的业务空间”;先做最小实验再下结论;区分模型、context、tool、workflow、harness 等层 | 背术语;看到新技术就套;把“模型更强”直接等同“产品值得做” |
| 机会判断 | 用户/场景、现有流程、痛点强度、AI 增量、频率、规模、支付/业务价值、风险 | 先还原用户原流程;找到高成本/高判断/高等待节点;比较 AI 与非 AI 解法;明确“不做”的理由 | 从“AI 能做什么”倒推需求;竞品做了就跟;没有 baseline |
| 方案判断 | 目标、约束、假设、拆解、替代方案、优先级、人机边界、MVP | 先共识目标再收敛;提出多个方案并明确为什么选 A 不选 B;主动管理风险和不可逆动作 | 一上来画大系统;功能堆砌;没有 trade-off |
| 评测判断 | “好”的定义、offline/online、过程/结果指标、grader、数据集、阈值、回归 | 在开发前写 acceptance criteria;建立 normal/edge/adversarial case;Bad Case 自动回流 | “用户觉得好”“准确率高”“上线后看看数据” |
| 收敛能力 | 核心问题选择、优先级、scope、决策纪律 | 面对 20 个问题只选择当前最值得解决的一个,并解释为什么另外 19 个暂时不做 | 每发现一个问题就加入 scope |
| AI 工作流设计 | 人/AI 分工、planning/execution、context、tools、checkpoint、escalation | 人控制目标、边界和验收;AI 承担大规模执行;高风险动作设置 gate;避免无意义人工逐步确认 | AI 只是“帮我写一下”;或者完全把目标和判断也丢给 AI |
| 学习方式变化 | 即时学习、实验验证、知识更新 | 遇到陌生技术先用 docs + experiment 获取最小可用理解,当天转化成 artifact | “我要先系统学两周 Agent” |
| 会忘 / 去路径依赖 | 重新验证旧最佳实践 | 模型/harness 变化后主动删除不再必要的 scaffold,并做回归验证 | 因为以前十节点 workflow 成功过就一直保持 |
| 知行合一 | 从未知到实验、边做边学 | 不懂 API 时不是先看完整课程,而是在安全沙箱里尽快做第一个有效调用并验证 | 学很多但没有可运行结果 |
| Eval 化能力 | 模糊反馈→测试案例 | 把“AI 经常跑偏”转成失败分类、触发条件、复现样本、grader 和回归测试 | Bad Case 停留在抱怨 |
| 工程闭环 | API、代码、数据、测试、部署、日志、权限、回滚 | 能使系统真正运行;知道失败在哪一层;有测试、日志和 recovery path | Demo 能跑一次即宣布完成 |
| 部署与采用 | 用户 adoption、培训、handoff、业务指标 | 系统上线后有人稳定使用,并证明改变了业务结果 | Demo ≈ 产品成功 |
| 复用沉淀 | abstraction、template、playbook | 第二个场景可以显著更快复制第一次成果 | 每次重新 prompt 一遍 |
这里尤其要注意两个误区。
第一,AI Native 不等于最大化 Agent 自主性。Anthropic 的真实使用研究显示,熟练用户会在某些场景给予 agent 更多执行自主权,但仍然通过监控和必要时中断实现监督;因此应考察的是“是否把正确的权力交给 AI”,不是“是否让 AI 做得最多”。[5]
第二,**“会忘”不是反知识,而是反路径依赖。**随着模型能力变化,harness 中过去为了弥补模型能力不足而加入的假设可能过时;Anthropic 2026 年的 managed-agent 工程文章明确提出,这类假设需要频繁重新审视。[6]
Agent 能力本身也必须在交互环境中测,而不能只靠问答。ReAct 把 reasoning 与 action 结合,通过与环境和工具交互更新行动;AgentBench 使用多个交互环境测 reasoning、decision-making 与 instruction-following;SWE-bench 则要求模型理解真实 repository、修改多个文件并通过测试;τ-bench 更进一步,把用户对话、工具调用、业务政策和最终数据库状态结合起来评价,并强调多次运行的一致性。[7]
因此这里不设计传统“AI 知识考试”,而采用行为任务组合。
训练与评测的标准循环如下:
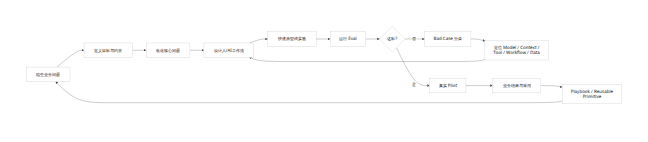
行为化测试电池
完整 G0 基线为 420 分钟左右,即 7 小时净测试时间,建议拆成两天或三个独立 session。每项任务都必须保存输入、回答、AI 会话、代码、trace、时间戳和最终 artifact。
这里有一个重要设计:部分题采用“双阶段”。
先让你短时间独立做判断,再允许 AI 全开。
这样可以分别得到:
个人判断能力 和 AI leverage 能力。
真正 AI Native 的人不是离开 AI 什么都不会,也不是有 AI 才显得厉害,而是:
自己能够把方向和验收标准定对,然后显著放大 AI 的执行能力。
| 任务 | 时间 | 输入 | 必须输出 | 主要评分点 | 单题通过 |
|---|---|---|---|---|---|
| 技术趋势判断 | 20m | 一项当前技术,如 Harness / Agent / Web Coding | 3 分钟观点 + 1 页决策 memo | 能力边界、业务影响、机会、限制、证据 | ≥70 |
| 旧架构淘汰挑战 | 20m | 一个旧式 12 节点 Agent workflow + 新模型条件 | 删除/保留/重构方案 | “会忘”、路径依赖、回归意识 | ≥70 |
| 机会筛选 | 25m | 8 个业务场景,只允许选 2 个做 AI | 排序矩阵 + 两个不做理由 | 真实需求、价值、AI 增量、成本风险 | ≥75 |
| 餐饮 Agent Case | 35m | 120 店投诉场景 | 6 项结构化答案 | 四判断 + 收敛 | ≥75 |
| 模糊需求 Discovery | 20m | CEO:“帮公司上一个 AI Agent” | 最多 12 个问题 + 初步 hypothesis | 信息价值、提问顺序、问题框定 | ≥75 |
| 架构选择 | 35m | 同一业务给 Single call / Workflow / Agent / Rules+AI 四种路径 | architecture memo + trade-off | 技术边界、人机分工、成本、风险 | ≥75 |
| AI 工作重构 | 30m | 一个传统 PM 工作流 | Before/After 工作流 | planning/execution 分工、checkpoint | ≥75 |
| Repo 调试 | 45m | 小型有 bug 的真实 repository | 复现→定位→patch→test | 工程理解、AI coding、验证纪律 | ≥70 |
| Agent 调试 | 40m | 有系统性失败的 Agent + trace | root cause + 修改 + 对比结果 | context/tool/workflow/model 区分 | ≥75 |
| Eval Spec | 35m | 一个生成式 AI 功能 | Eval 数据集设计 + grader + threshold | what-good-means、edge、adversarial | ≥80 |
| Bad Case 复现 | 30m | 10 条失败日志 | taxonomy + minimal repro + regression cases | 可复现性、根因、回流 | ≥80 |
| Production Incident | 30m | 延迟、成本上涨、误操作组合事故 | incident diagnosis + rollback plan | observability、风险、工程闭环 | ≥75 |
| 即时学习挑战 | 25m | 一个此前没使用过的 API/工具文档 | 最小实验 + 结论 + 下一步 | time-to-first-experiment、验证习惯 | ≥70 |
| 复用与 Handoff | 30m | 前述某个成功 case | 1 页 Playbook + 5 分钟讲解 | abstraction、可复用、沟通清晰度 | ≥75 |
统一行为评分锚点采用 0–4:
| 分值 | 行为定义 |
|---|---|
| 0 | 不知道怎么做,或方案会明显造成风险 |
| 1 | 会说名词和框架,但无法转换成决策 |
| 2 | 方向基本合理,但假设隐藏、证据不足、不可复现 |
| 3 | 目标清晰,有 trade-off、可执行、可验证 |
| 4 | 可复现、量化、生产意识明确,并能够根据反馈迭代系统 |
这里刻意避免“表达得像专家就高分”。
例如:
“我觉得可以用 Agent 来做。”
最多 1 分。
“这个环节包含开放判断与多工具调用,因此 Agent 有价值;但优惠券发放是不可逆动作,我会把金额规则放 deterministic policy 层,Agent 只在高置信、低风险 case 自动执行;第一阶段 shadow mode,达到 X 阈值后才逐步开放执行。”
才进入 3–4 分。
评测任务的设计参考 OpenAI 当前 eval 方法:先定义 objective,再收集数据,定义 metric,运行对比并持续评测;数据应覆盖真实分布以及 typical、edge、adversarial cases,自动 grader 需要用人类反馈校准。[8]
工程任务必须使用真实执行反馈,而非“看代码觉得对”。SWE-bench 的核心设计就是要求 agent 在真实 repository 中编辑代码并由测试验证结果,这比孤立的代码生成更接近 FDE 实际工作。[9]
量化评分与 Gates
为了防止出现一个典型问题——“产品判断很强,把工程和 Eval 的低分平均掉,最后总分看起来还不错”——本体系不采用单纯总分制,而是:
总分 + 关键能力底线 + Artifact Gate。
评分权重如下:
| 能力 | 权重 |
|---|---|
| 技术判断 | 10 |
| 机会判断 | 10 |
| 方案判断 | 10 |
| 评测判断 | 12 |
| 收敛与优先级 | 10 |
| AI 工作流设计 | 12 |
| 学习 / 会忘 / 即时实验 | 6 |
| 工程闭环 | 14 |
| Bad Case 调试 | 8 |
| 部署采用与复用 | 8 |
| 总计 | 100 |
单维度换算公式:
其中 是任务 在维度 上的 0–4 行为分。
总分:
这里 是上表对应百分比权重。
但任何一个候选人,即使总分 85,评测判断只有 45 或工程闭环只有 40,也不能认为已经具备 FDE 能力。
能力等级建议定义为:
| 总分 | 判定 |
|---|---|
| <50 | AI 使用者 |
| 50–59 | AI-assisted PM / Builder |
| 60–69 | 初级 AI Native |
| 70–79 | 可独立完成 AI 产品小闭环 |
| 80–89 | 强 AI Native / 准 FDE |
| ≥90 | 高水平 FDE 行为表现,需真实生产项目继续验证 |
最后一句很重要:
90 分也不等于“你就是 FDE”。
因为真实 FDE 的定义包含生产环境、客户协作、采用和持续责任,这些无法完全由模拟题证明。OpenAI 当前岗位也把 stable production、adoption、workflow impact 和 handoff 看成最终结果,而不只是 prototype。[1]
G0–G9 采用以下硬门槛:
| Gate | 核心验证 | 通过条件 |
|---|---|---|
| G0 基线 | 得到真实能力画像 | 完成 ≥95% 测试证据;不要求最低分 |
| G1 问题定义与收敛 | 不发散 | 收敛维度 ≥70;Case 能明确 1 个 primary problem、1 个 primary outcome |
| G2 AI Native 工作方式 | AI 不只是助手 | AI Workflow ≥70;至少一个重复任务经调试后连续 3 次稳定完成 |
| G3 四大判断 | 技术/机会/方案/Eval | 四项分别 ≥70;评测 ≥75 |
| G4 FDE Discovery | 陌生业务快速理解 | Discovery case ≥75;问题、workflow、约束、价值能够闭环 |
| G5 Solution Architecture | 做正确系统 | Architecture ≥75;必须提供 ≥2 个替代方案及 trade-off |
| G6 Prototype & Build | 真正做出来 | Engineering ≥70;系统可运行;关键 tests 通过 |
| G7 Eval & Production | 能证明和稳定 | Eval ≥80;关键安全/权限规则必须 100% 通过;有 regression set |
| G8 Deployment & Adoption | 有人真正使用 | 至少完成一个 pilot;有 baseline、结果、用户 adoption 证据和 rollback |
| G9 Reusable Playbook | 一次→一类 | 第二个类似 case 可以用 playbook 重建;新操作者可按照文档完成主要流程 |
这里采用“多个 case + 多次行为观察”而不是一次大面试。开放题本身存在评分者判断空间;ETS 把 inter-rater reliability 视为评分质量的重要组成部分,NCME 也把它定义为不同评分者对表现评分的一致程度。因此关键能力至少应在多个任务上被重复观察,而不能因为某一道题“正好会”就判断掌握。[10]
示例雷达图仅展示报告呈现形式,并不是你的真实成绩:
示例 AI Native × FDE 能力雷达图
示例数据为:技术 52、机会 70、方案 58、Eval 42、收敛 45、AI Workflow 65、工程闭环 48、复用 55。真正 G0 完成后才会生成你的个人雷达图。
强化培训课程
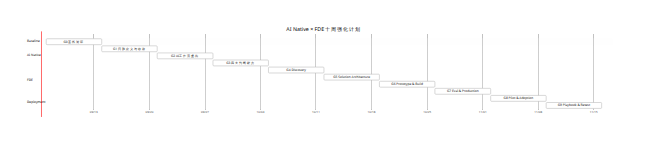
课程采用 10 周 Gate 制。
不是“第 4 周到了所以进入下一课”,而是:
Gate 不过,重复训练。
训练内容遵循 OpenAI 所强调的 eval-driven feedback loop:建立任务、执行、记录失败、定义成功标准、回归验证并持续扩大 eval set。[11]
| 周次 | 核心目标 | 训练任务 | 必须交付 | Checkpoint |
|---|---|---|---|---|
| Week 1 | G0 基线 | 完成 14 项测试中的核心 8 项 | Baseline Report + Radar + Top 5 gaps | G0 |
| Week 2 | 收敛 | 每天 1 个开放 Case,限时 20m | 5 份 Problem Brief + Decision Log | G1 |
| Week 3 | AI Native 工作方式 | 把 3 个你现在人工/半人工任务重构为 AI-first | Before/After Workflow + 1 个稳定 workflow | G2 |
| Week 4 | 四大判断 | 技术趋势、机会筛选、方案取舍、Eval | 4 份 Decision Memo | G3 |
| Week 5 | FDE Discovery | 进入陌生垂直场景,访谈/模拟 stakeholder | Workflow Map + Constraint Map + ROI hypothesis | G4 |
| Week 6 | 架构 | Single call / Rules / RAG / Workflow / Agent 比较 | Architecture RFC | G5 |
| Week 7 | Build | AI Coding 完成可运行 prototype | Repo + README + Tests + Demo | G6 |
| Week 8 | Eval + Debug | 50–100 条 eval、Bad Case taxonomy | Eval Spec + Dataset + Regression Report | G7 |
| Week 9 | Pilot | 找真实用户或真实工作任务 | Pilot Result + Adoption + Business Metrics | G8 |
| Week 10 | 复用与复测 | 将成果复制到第二场景 + 重做 G0 | Playbook + Final Radar + Before/After | G9 |
时间线以 2026 年 9 月 7 日开始计算:
整个项目的日常训练循环固定为:
一次陌生题 → 20 分钟回答 → 严格打分 → 只选一个最弱点 → 重答 → 现实验证 → 写入 Personal Bad Case Library。
这里不会让你每天学习十个概念。
例如第二周专门训练你的一个潜在高风险行为:
“看到太多问题,因此做一个过大的系统。”
练习会故意给你:
“20 个问题、3 种用户、8 个机会、有限资源。”
然后要求:
只能选一个。
不能回答:
“我认为 A、B、C 都比较重要,可以分阶段……”
这仍然没有完成判断。
你必须给:
“第一阶段只做 B,因为 B 的发生频率×单次损失×AI 可改善程度最高;A 虽然严重但频率低并需要高风险自动决策;C 可以由规则系统解决,不值得引入 LLM。因此四周内只验证 B。”
第三周训练则不会问:
“你怎么用 AI?”
而是直接给一个工作:
“分析 300 条用户反馈,并产生下一版本优先级。”
我们会观察你是不是:
上传 → “帮我总结一下” → 手工重写。
还是:
定义 schema → AI 分类 → confidence → clustering → evidence linking → 人 check 高风险判断 → 生成 backlog → 结果复核 → 将 bad case 加入 workflow。
OpenAI 的 Harness Engineering 案例非常适合作为训练原则:系统的目标不是让 agent “更努力”,而是使环境、context、工具、日志和反馈对于 agent 足够可理解和可操作,从而提高其可靠完成任务的能力。[2]
第八周会特别严格。生成式系统具有非确定性,因此传统“一条 case 成功”不足以证明可靠。OpenAI 当前指南强调用结构化 eval、日志、连续评测和人类校准;τ-bench 也使用多次运行指标考察 agent 是否能够在重复任务中稳定遵守规则,而不是偶尔成功。[12]
因此我们至少要求:
正常 case / 边界 case / 对抗 case / 真实 Bad Case / 回归 case。
第九周以后,产品“不再以 Demo 是否好看”为主要标准。
要看:
是否有人用、使用频率是否稳定、人工时间是否下降、错误是否受控、业务结果是否改善。
这也正是当前 OpenAI FDE 把 production adoption 和 measurable workflow impact 写进岗位成功标准的原因。[13]
远程测评与评分可靠性
远程评测最重要的不是开一个 Zoom,然后问开放题。
必须记录整个解决问题的过程证据。
建议每次 assessment 保存以下数据:
| 证据 | 用途 |
|---|---|
| 屏幕 + 麦克风录制 | 判断实际操作过程 |
| Candidate ID | 匿名评分 |
| Task start/end timestamp | 判断速度与收敛 |
| 所有 prompts | 判断 AI 工作流能力 |
| Model/version | 避免模型差异污染比较 |
| Tool calls / trace | 判断 Agent 决策路径 |
| Git commit / diff | 判断真实工程行为 |
| Tests / Eval results | 判断是否验证 |
| Decision Log | 判断 trade-off |
| Final artifact | 判断最终完成度 |
| Self-review | 判断是否能识别自己的失败 |
Agent 项目最好记录完整 trace。OpenAI 的 agent evaluation 文档指出,trace 可以完整记录 model calls、tool calls、guardrails 和 handoffs,并可以通过 grader 判断是否选对工具、是否错误 handoff、是否违反指令,以及修改 prompt 或 routing 后端到端行为是否改善。[14]
建议远程过程采用:
任务页 + 视频录制 + Git repository + trace/eval 系统 + 标准评分表。
不要求特定厂商。
但如果使用 OpenAI 当前工具链,需要注意一个时间敏感变化:截至 2026 年 9 月 6 日,OpenAI 文档已经注明旧 Evals Platform 将在 2026 年 10 月 31 日变为只读,并计划于 2026 年 11 月 30 日关闭;因此新体系应优先基于当前 datasets、agent traces、graders 和 eval runs 等能力,而不是把基础设施绑定在旧 Evals 平台上。[15]
人工评分建议采用:
双评分者 + Blind Scoring + Anchor Responses + Adjudication。
高风险任务至少抽取 30% 做双人独立评分;正式 Gate 可以全部双评。评分者看不到姓名、历史分数和另一评分者结果。
本项目设定以下内部质量标准,注意这些是本项目设计阈值,而不是声称存在某个行业统一标准:
连续维度分数:目标 ICC ≥ 0.80;
0–4 等级项:目标 weighted κ ≥ 0.70;
单一 criterion 差异 >1 级:自动复核;
总分差 >8 分:第三人仲裁;
每 20 个样本重新加入 anchor response 检查 rater drift。
ETS 对构答题评分的研究强调 inter-rater reliability 是评分可靠性的组成部分;因此评分者一致性本身也必须被测量,而不能把 rubric 写完就默认评分可靠。[16]
LLM 可以参与评分,但只能做:
预评分 / evidence extraction / consistency check。
不能一开始就让同一个模型既当“考生助手”又当“唯一裁判”。
OpenAI 的 eval 指南同样明确建议自动评测使用人类反馈持续校准。[17]
匿名评分数据建议保存:
candidate_id task_id task_version model_used started_at finished_at
criterion rater_A_score rater_B_score adjudicated_score
evidence_pointer critical_failure comments
这样以后才能回答:
“你的方案判断提高了。”
而不是仅凭印象。
真正应该输出的是:
G0 方案判断 56 → Week 4 72 → Final 83 证据覆盖:4 个独立 Case 双评分者 ICC:0.86 最大残留问题:高风险场景中的 rollback 设计。
这才叫能力测量。
附录:评分锚点、模板与餐饮案例
餐饮 Agent 基线题满分锚点
场景仍采用前面那道题:
120 家门店、25 名运营、评价/投诉流程,希望 AI Agent 将人工工作量减少 50%、提升评分;有两年历史数据、订单/退款/客服记录;Agent 最多自动发 20 元优惠券;退款人工确认;成本 <3 万/月;不允许严重误赔。
理想回答不是立刻说:
“我们做一个多 Agent 系统。”
而应该从价值和风险开始。
| 问题 | 满分回答核心 | 分值 |
|---|---|---|
| 值不值得做 | 有条件值得验证。流程高频、重复、信息检索量大、部分决策可标准化,而且人工成本和响应时效可以量化;但先确认每天投诉量、平均处理时间、赔付率、当前误判率、差评恢复率。不是因为 Agent 热门才做。 | 15 |
| 用户/问题 | 直接用户是总部运营与门店,最终受益者是顾客。核心问题不是“回复差评慢”,而是投诉处理链中大量检索、归因和政策执行占用人力,导致响应慢且标准不一致。 | 15 |
| 流程拆解 | ingest → 绑定订单 → 意图/严重度 → 拉取证据 → 归责 → 赔付政策 → 回复 → 执行动作 → 门店反馈 → closure。 | 15 |
| AI / 人分工 | AI:分类、证据检索、摘要、常规归因建议、回复生成、规则允许情况下低风险优惠券。Rules:金额和政策硬限制。Human:退款、证据冲突、食品安全、法律威胁、高额或不可逆动作。 | 20 |
| 第一版 Scope | 先选高频低风险投诉,最好先 10–20 家店或一个渠道;shadow mode → assisted → limited auto-execution。明确不做退款、食品安全、舆情、法律投诉等。 | 15 |
| Eval | Offline task metrics + end-to-end metrics + business outcome + guardrail。误赔严重 case=0;成本 <3 万;定义人工分钟数、自动完成率、first response time、reopen/escalation 等;评分提升需要 pilot/A-B 或准实验,避免把自然波动当 AI 效果。 | 20 |
一个高水平候选人还会主动指出:
CEO 的“提高门店评分”是一个 lagging business outcome,不能直接用来优化模型。
因为评分同时受到菜品、服务、配送、节假日、门店经营变化等因素影响。
因此第一阶段应该建立较短反馈周期:
任务正确性 → 投诉解决质量 → 用户恢复结果 → 门店评分。
这就是“评测判断”。
理想的第一版架构也不会让 LLM 在几十万历史记录里“自由发挥”,而更可能采用:
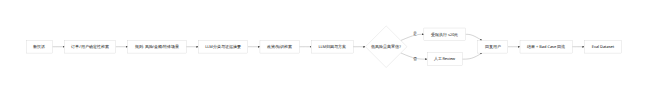
这种 deterministic tools + LLM judgment 的组合也符合当前 Agent 工程的一般经验:Anthropic 在一些科学 agent 场景中观察到,加入确定性 retrieval 工具后可靠性显著改善;更广义的 agent 设计也通常把 retrieval、tools 和 memory 当作增强 LLM 的基础构件,而不是让模型独自承担所有系统行为。[18]
AI PRD 模板
Problem
- 谁?
- 在什么情况下?
- 当前怎么做?
- 最痛的步骤是什么?
- Baseline 是什么?
Outcome
- 用户结果:
- 业务结果:
- 不优化什么:
AI Opportunity
- 为什么 AI 比规则/搜索/传统软件更合适?
- 模型真正负责哪种判断?
- 已知能力边界:
Workflow
- Input
- Retrieval/Data
- Rules
- Model decisions
- Tools
- Human checkpoints
- Actions
Scope
- V1 做:
- 明确不做:
Failure Modes
- F1:
- F2:
- F3:
Acceptance Criteria
- Quality:
- Safety:
- Cost:
- Latency:
- Business:
Rollout Shadow → Assisted → Limited Automation → Expanded Automation
Eval Spec 模板
Eval Objective 我们究竟在验证什么?
Unit of Evaluation 一次回答 / 一个decision / 一条trajectory / 整个workflow?
Dataset Normal: Edge: Adversarial: Historical Bad Cases: Production sample:
Dimensions Correctness: Completeness: Policy compliance: Tool selection: User outcome: Safety:
Graders Rule-based: Programmatic: LLM judge: Human expert:
Threshold Launch: Blocker: Critical failure:
Repeated Runs 每个关键case运行次数: 一致性指标:
Bad Case Taxonomy Model: Context: Retrieval: Tool: Workflow: Data: Policy: Human interaction:
Regression 每次改变 prompt/model/tool/workflow 后重新运行哪些cases?
OpenAI 当前 Agent Eval 方法也建议在调试阶段先用 trace 找到工作流层问题,在明确“什么叫好”以后,再把代表性 cases 固化成 dataset 和 repeatable eval runs。[14]
FDE Playbook 模板
Use Case 解决哪一类问题?
Entry Criteria 满足什么条件才值得使用本方案?
Discovery 必须确认的10个信息:
Reference Workflow 业务原流程:
Reference Architecture 默认系统结构:
Human / AI Boundary 自动执行: 需审批: 禁止自动:
Default Evals 必须通过哪些测试:
Failure Patterns 常见失败: 诊断方法: 修复方式:
Deployment Shadow: Pilot: Rollout: Rollback:
Observability Logs: Metrics: Traces: Alerts:
Economics 成本模型: ROI计算:
Handoff 客户/用户需要知道什么?
Reusable Assets Prompt: Tool: Code: Dataset: Eval: Checklist:
Personal Gap Report 模板
| 项目 | 内容 |
|---|---|
| 当前总分 | __ /100 |
| 可信度 | 高 / 中 / 低;基于 __ 个独立行为样本 |
| 当前 Gate | G__ |
| 最强能力 | __ |
| 最大瓶颈 | __ |
| 第二瓶颈 | __ |
| 第三瓶颈 | __ |
| 典型错误行为 | __ |
| 典型错误假设 | __ |
| 证据 | Task __ / timestamp __ |
| 当前 Bad Case | __ |
| 纠正训练 | __ |
| 下次证明任务 | __ |
| 通过条件 | __ |
| 不允许的逃避行为 | __ |
你的报告不会只写:
“加强技术学习。”
这种建议没有执行意义。
会写成类似:
问题:方案收敛 43/100。 4 个 Case 中有 3 个在没有确定 Primary Outcome 前进入功能设计;平均每题提出 5.2 个一级目标。 **根因假设:**把“发现更多问题”误认为“分析更深入”。 **两周训练:**每天一个 20 分钟 Case,答案强制只允许 1 个用户、1 个问题、1 个 North Star、1 个 V1。 **重新验证:**连续 4 个陌生 Case,收敛维度 ≥75,无单题 <70。
或者:
问题:Eval 化能力 51/100。 你能够识别 Bad Case,但 70% 的描述停留在“模型理解错/忘了需求”,没有 minimal reproduction、failure taxonomy 和 regression case。 **训练目标:**每遇到一次 AI 错误,不允许手改最终答案,必须首先把错误归入 Model / Context / Retrieval / Tool / Workflow / Data / Policy 七层之一,并建立复现测试。
这才是真正的个性化培训。
而这套计划里我认为对你最重要的一条纪律会是:
从现在开始,我们不奖励你“想得多”,只奖励你“判断得准、收敛得快、做得出来、测得清楚、能够复用”。
因为对于 AI Native + FDE,最稀缺的已经越来越不是“自己完成多少执行”,而是把目标定义正确、构造 AI 能有效执行的环境、建立反馈和验证机制,并在复杂和模糊条件下把系统真正交付出去。这与 OpenAI 当前 agent-first 工程实践和 FDE 岗位所强调的环境设计、scope/sequence、代码参与、生产交付、eval feedback 与可复用模式高度一致。[19]
[1] [13] Forward Deployed Engineer (FDE) - SF | OpenAI
https://openai.com/careers/forward-deployed-engineer-%28fde%29-sf-san-francisco/
[2] [19] Harness engineering: leveraging Codex in an agent-first world | OpenAI
https://openai.com/index/harness-engineering/
[3] How Claude Code is used in practice \ Anthropic
https://www.anthropic.com/research/claude-code-expertise
[4] [8] [12] [15] [17] Evaluation best practices | OpenAI API
https://developers.openai.com/api/docs/guides/evaluation-best-practices
[5] Measuring AI agent autonomy in practice
https://www.anthropic.com/research/measuring-agent-autonomy?utm_source=chatgpt.com
[6] Scaling Managed Agents: Decoupling the brain from …
https://www.anthropic.com/engineering/managed-agents?utm_source=chatgpt.com
[7] ReAct: Synergizing Reasoning and Acting in Language Models
https://arxiv.org/abs/2210.03629?utm_source=chatgpt.com
[9] SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
https://arxiv.org/abs/2310.06770?utm_source=chatgpt.com
[10] [16] An Interesting Problem in the Estimation of Scoring Reliability
[11] [14] Evaluate agent workflows | OpenAI API
https://platform.openai.com/docs/guides/agent-evals
[18] Paving the way for AI agents in biology
https://www.anthropic.com/research/agents-in-biology?utm_source=chatgpt.com